

Repository
top-cvpr-2024-papers
Computer Vision and Pattern Recognition is a massive conference. In papers were submitted, and were accepted. I created this repository to help you search for crème de la crème of · License unknown · Maintenance unknown
- License
- Unknown
README
<br>
👋 hello
Computer Vision and Pattern Recognition is a massive conference. In 2024 alone,
11,532 papers were submitted, and 2,719 were accepted. I created this repository
to help you search for crème de la crème of CVPR publications. If the paper you are
looking for is not on my short list, take a peek at the full
list of accepted papers.
🗞️ papers and posters
🔥 - highlighted papers
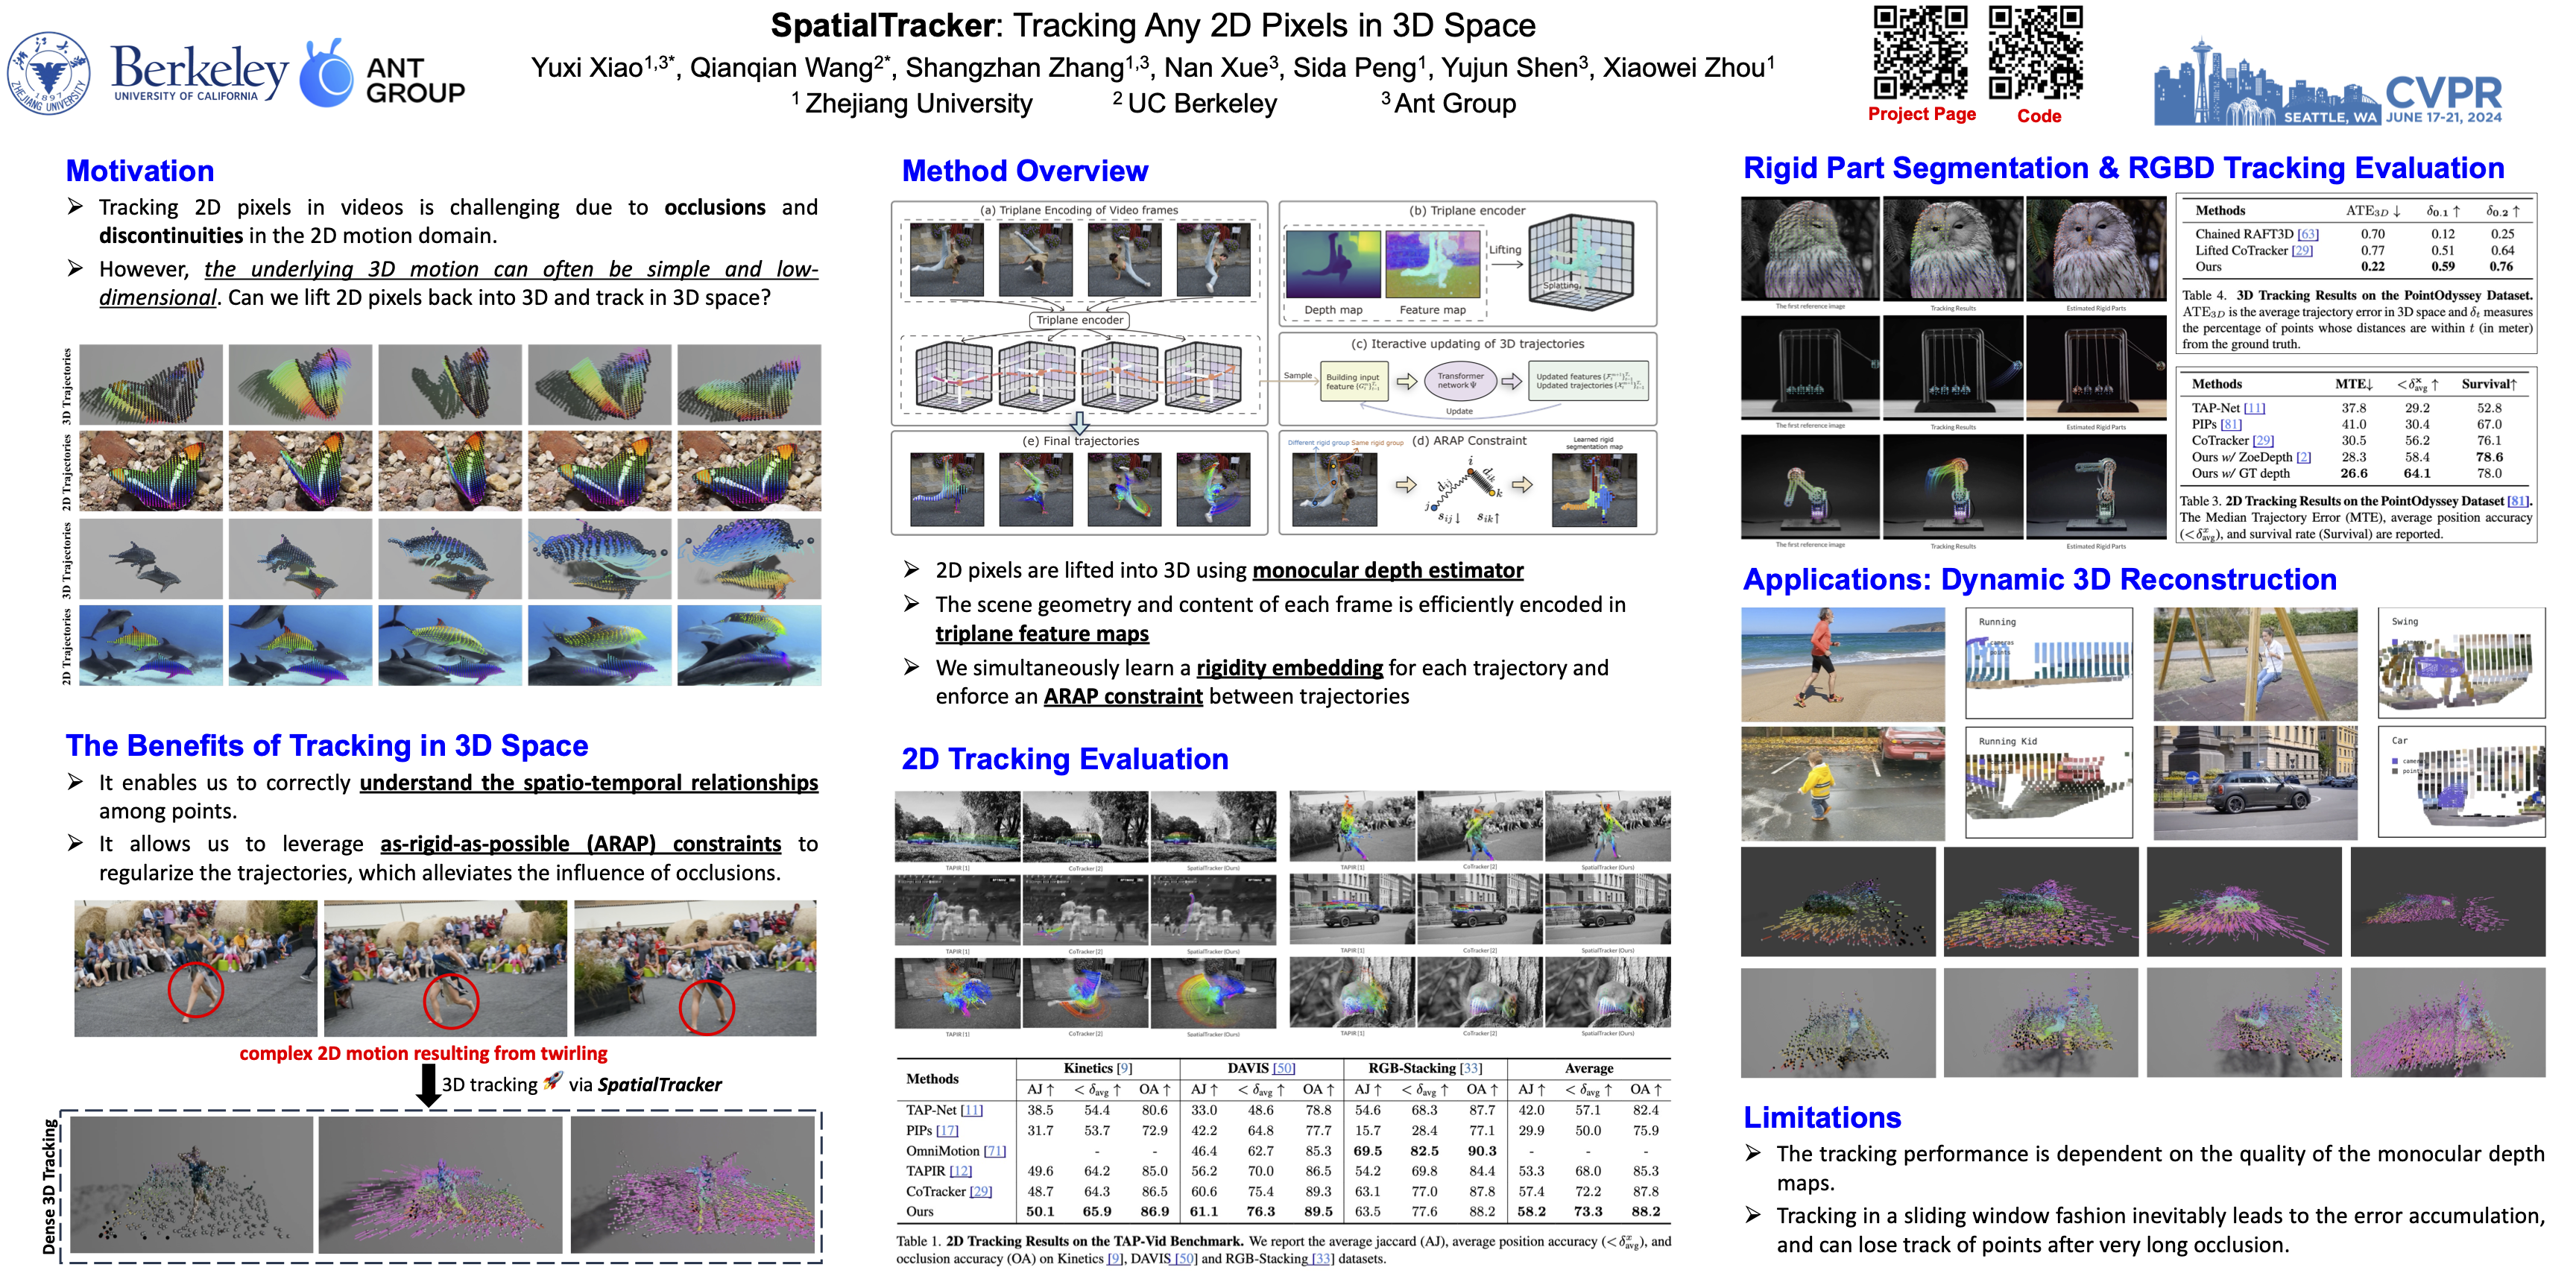
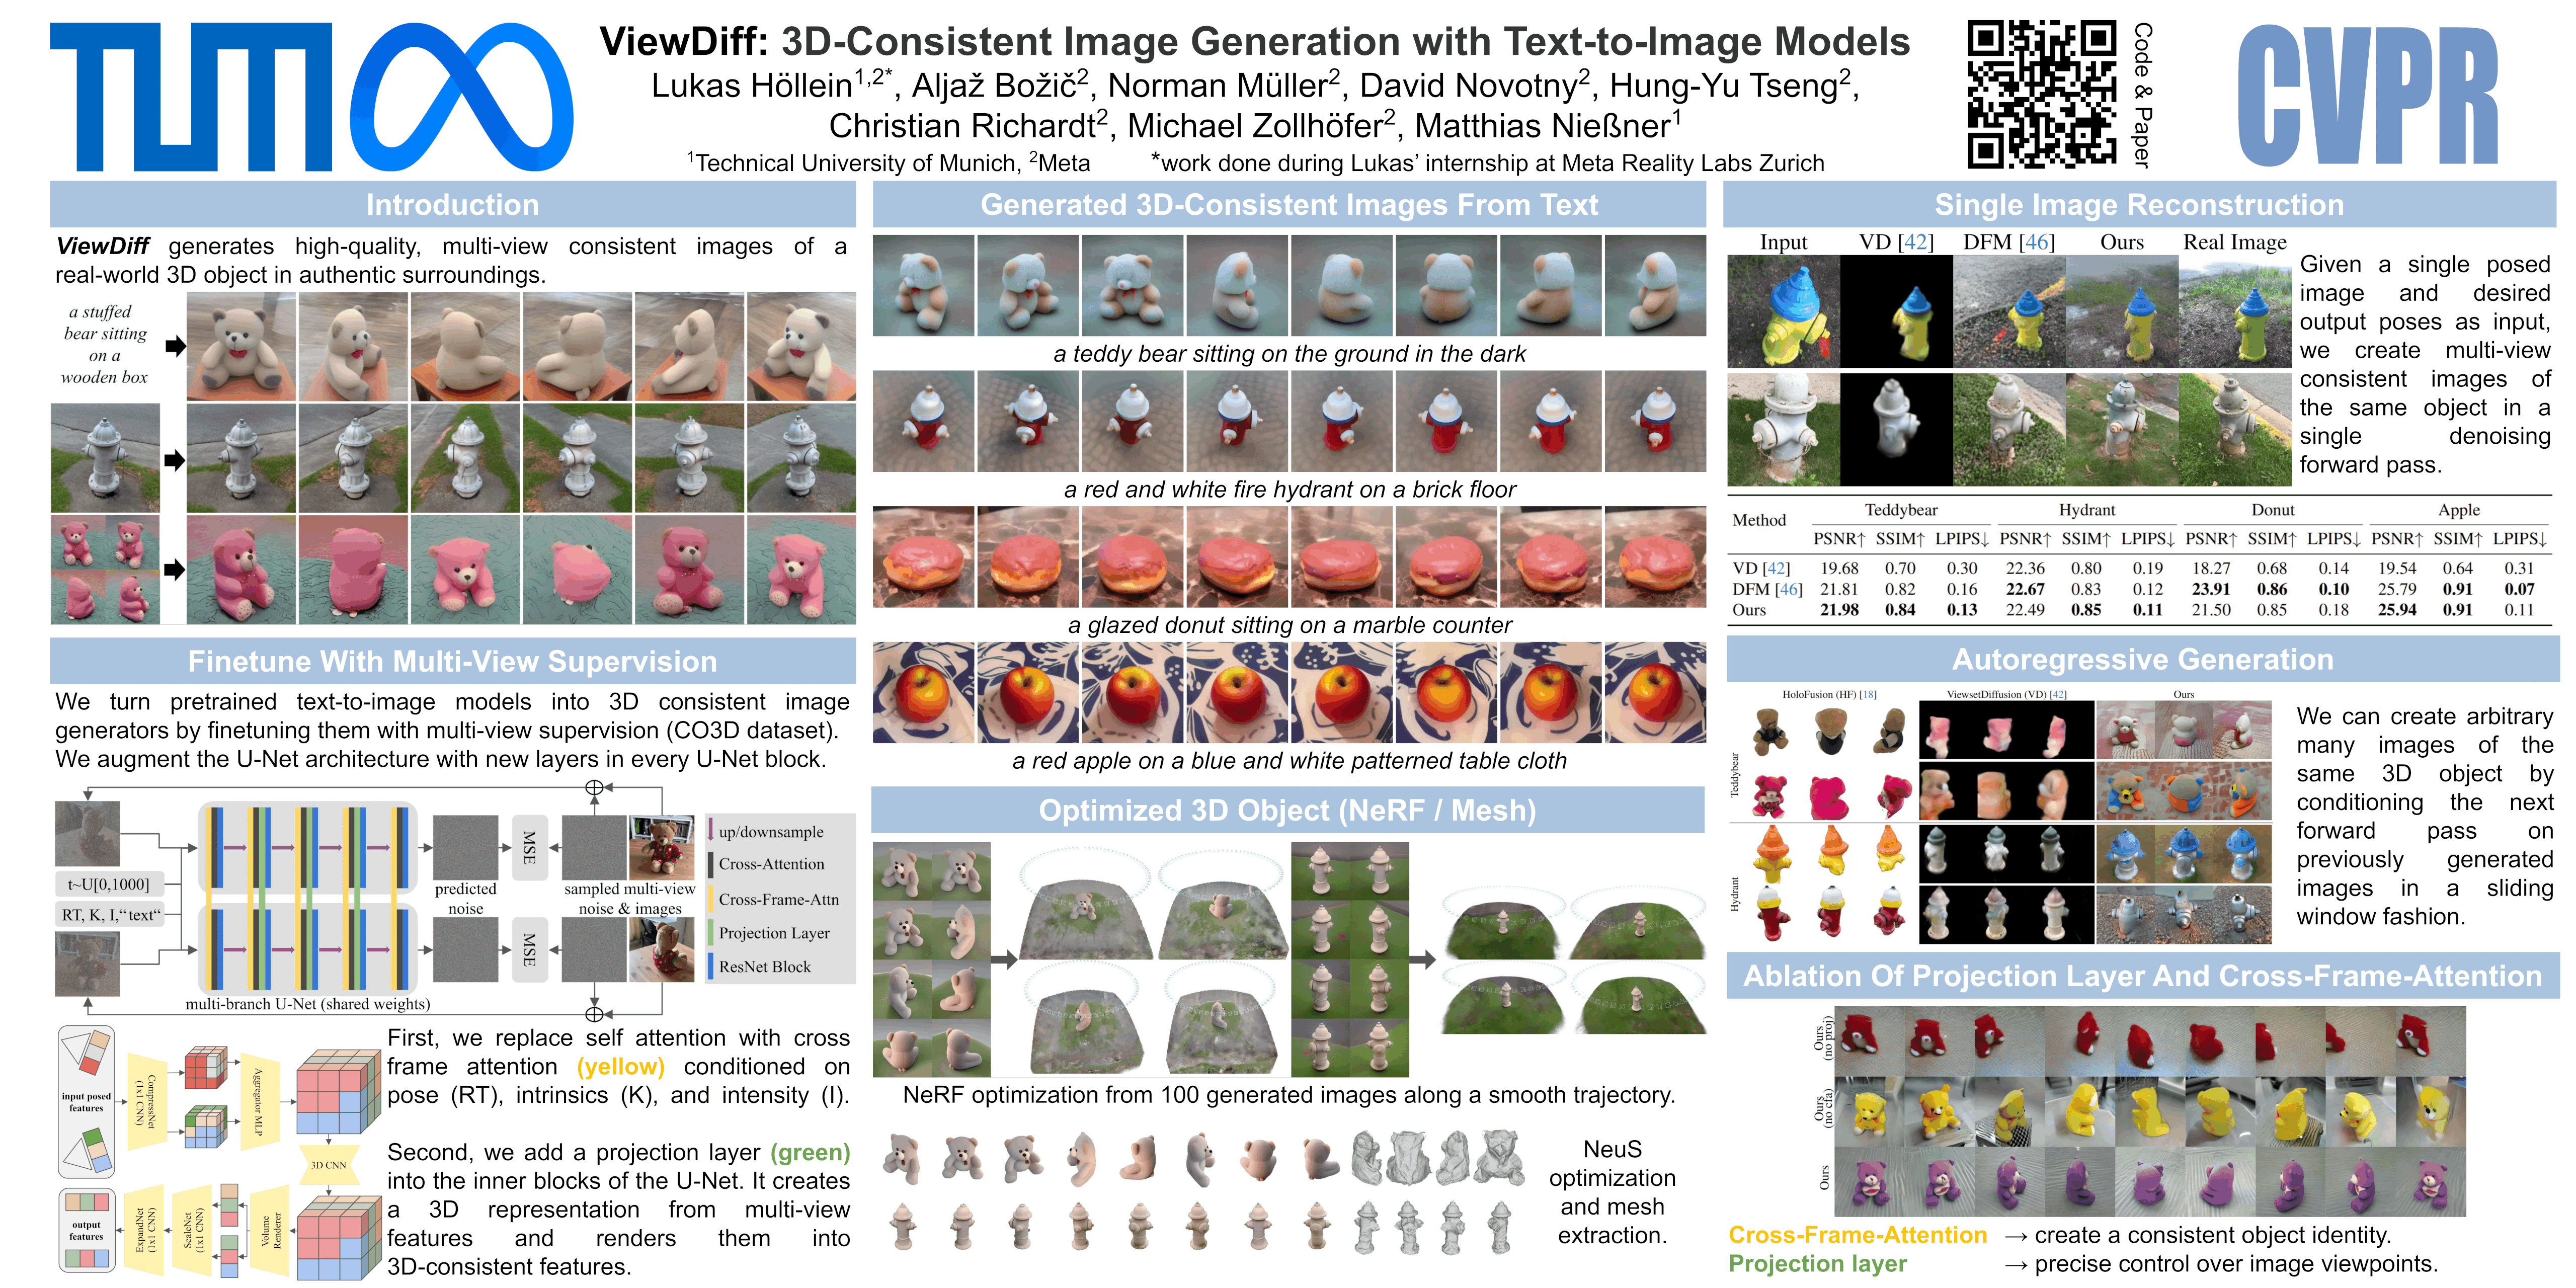
3d from multi-view and sensors
<br/>
<br/>
<br/>
<br/>
OmniGlue: Generalizable Feature Matching with Foundation Model Guidance Hanwen Jiang, Arjun Karpur, Bingyi Cao, Qixing Huang, Andre Araujo [paper] [code] [demo] Topic: 3D from multi-view and sensors Session: Fri 21 Jun 1:30 p.m. EDT — 3 p.m. EDT #32
<br/>
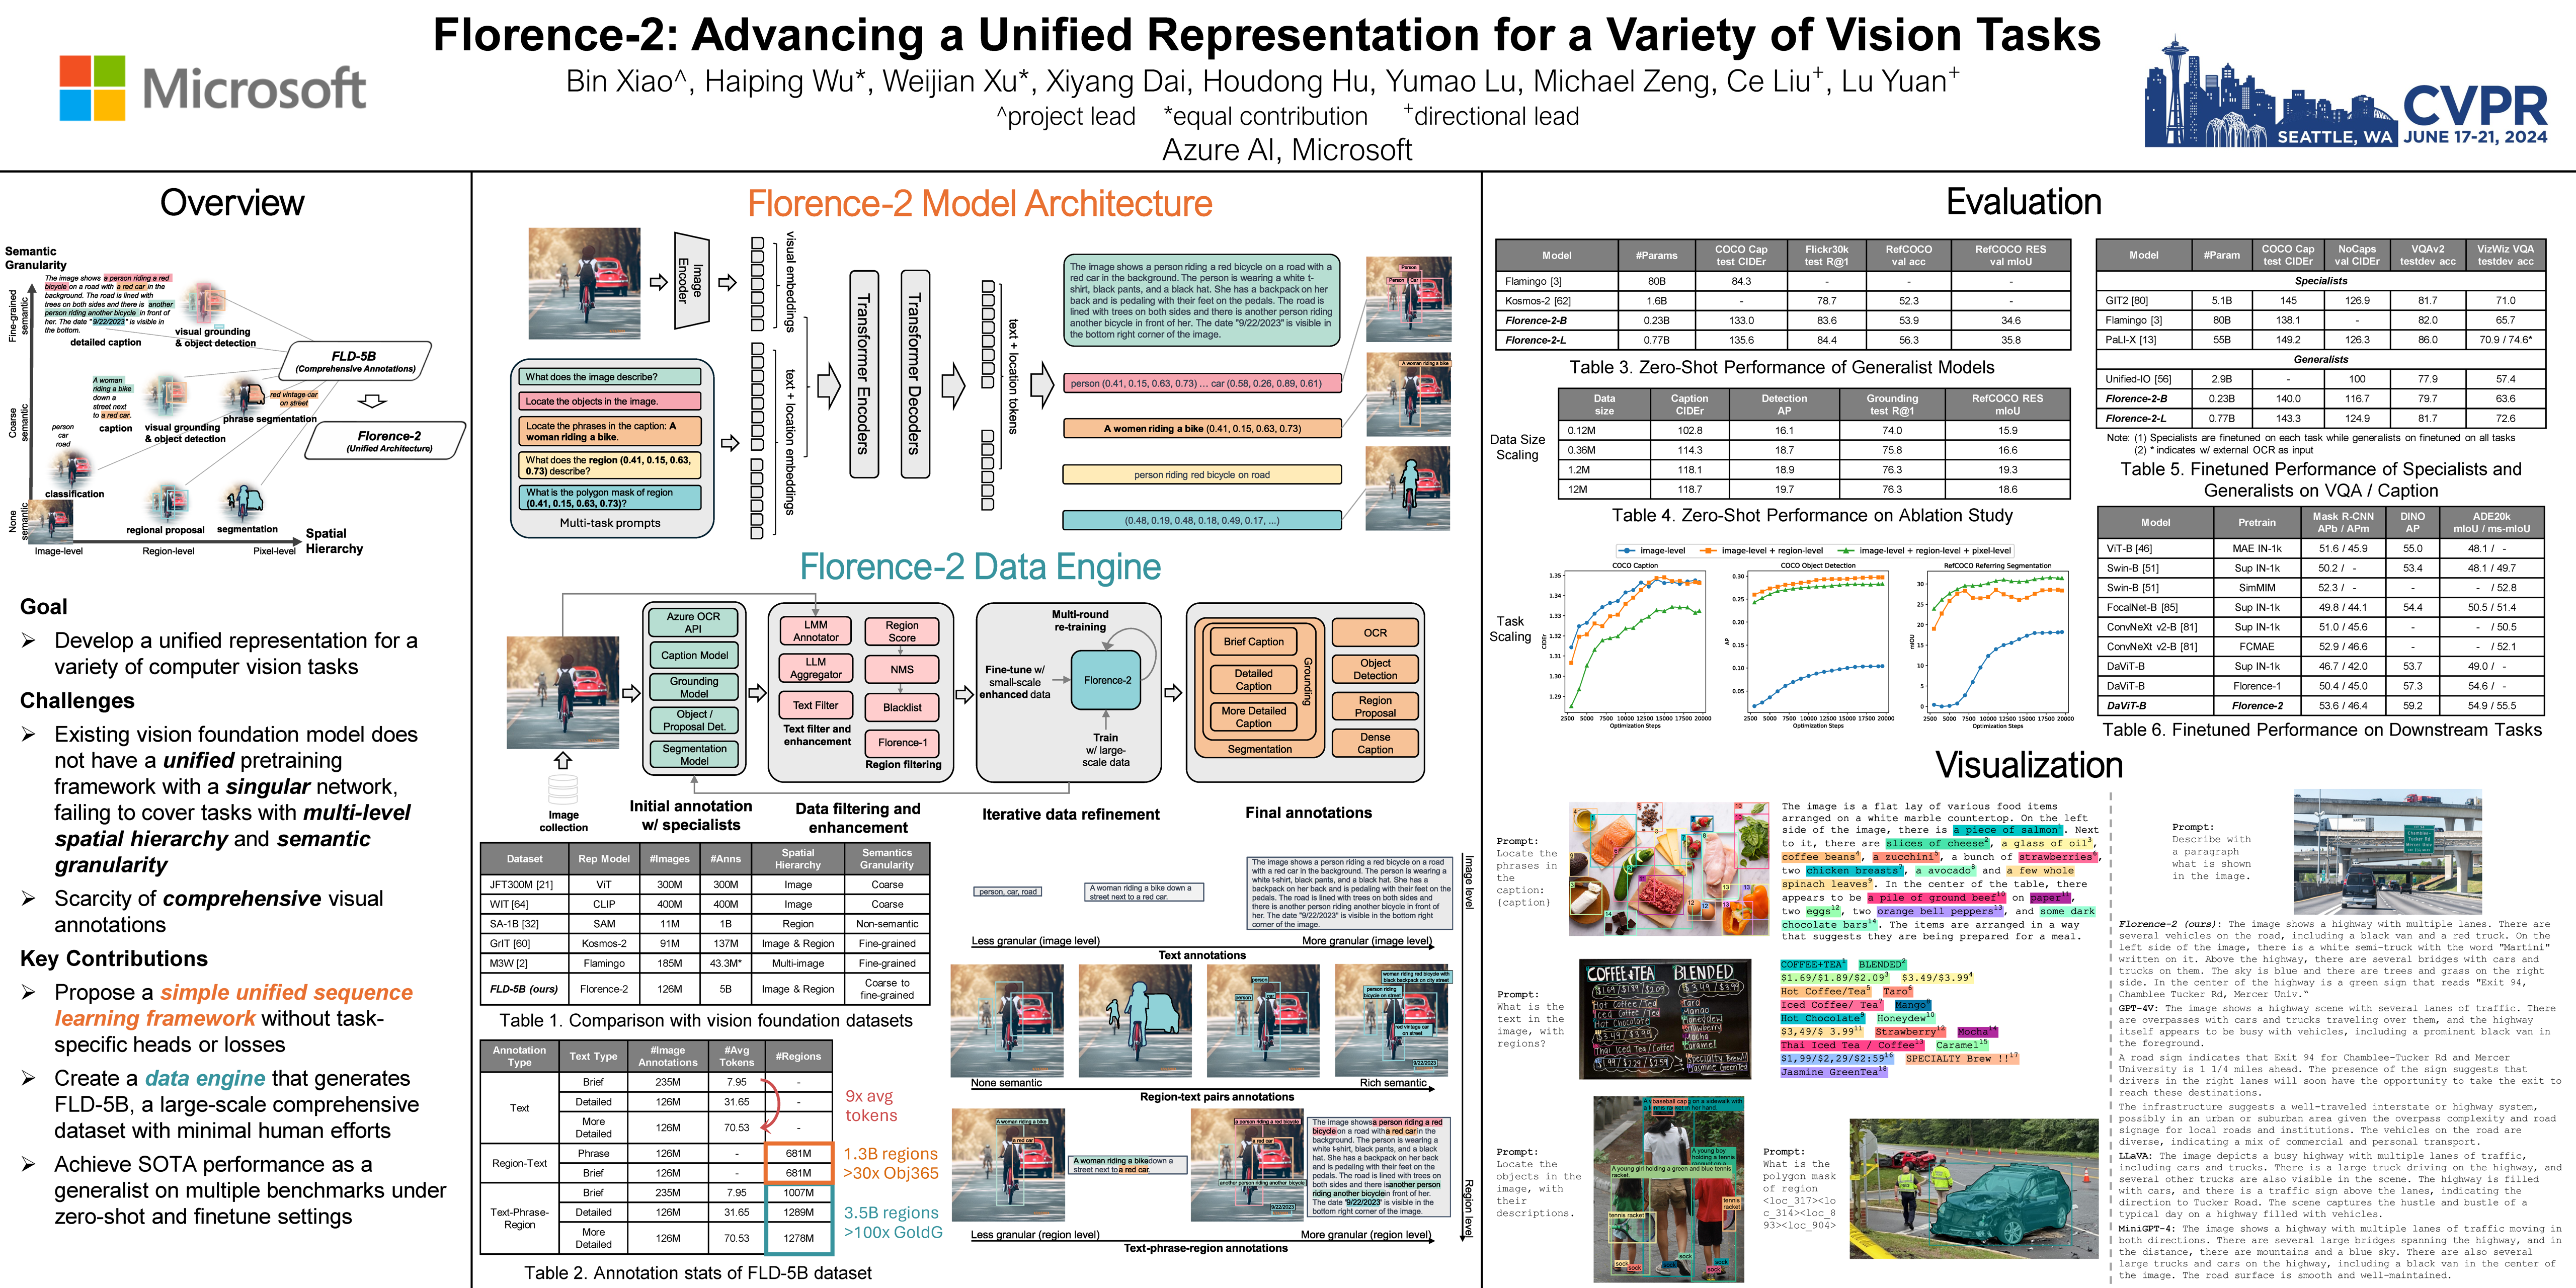
deep learning architectures and techniques
<br/>
<br/>
document analysis and understanding
DocRes: A Generalist Model Toward Unifying Document Image Restoration Tasks Jiaxin Zhang, Dezhi Peng, Chongyu Liu, Peirong Zhang, Lianwen Jin [paper] [code] [demo] Topic: Document analysis and understanding Session: Thu 20 Jun 8 p.m. EDT — 9:30 p.m. EDT #101
<br/>
efficient and scalable vision
🔥 EfficientSAM: Leveraged Masked Image Pretraining for Efficient Segment Anything
Yunyang Xiong, Bala Varadarajan, Lemeng Wu, Xiaoyu Xiang, Fanyi Xiao, Chenchen Zhu, Xiaoliang Dai, Dilin Wang, Fei Sun, Forrest Iandola, Raghuraman Krishnamoorthi, Vikas Chandra
[paper] [code] [demo]
Topic: Efficient and scalable vision
Session: Thu 20 Jun 8 p.m. EDT — 9:30 p.m. EDT #144
<br/>
<br/>
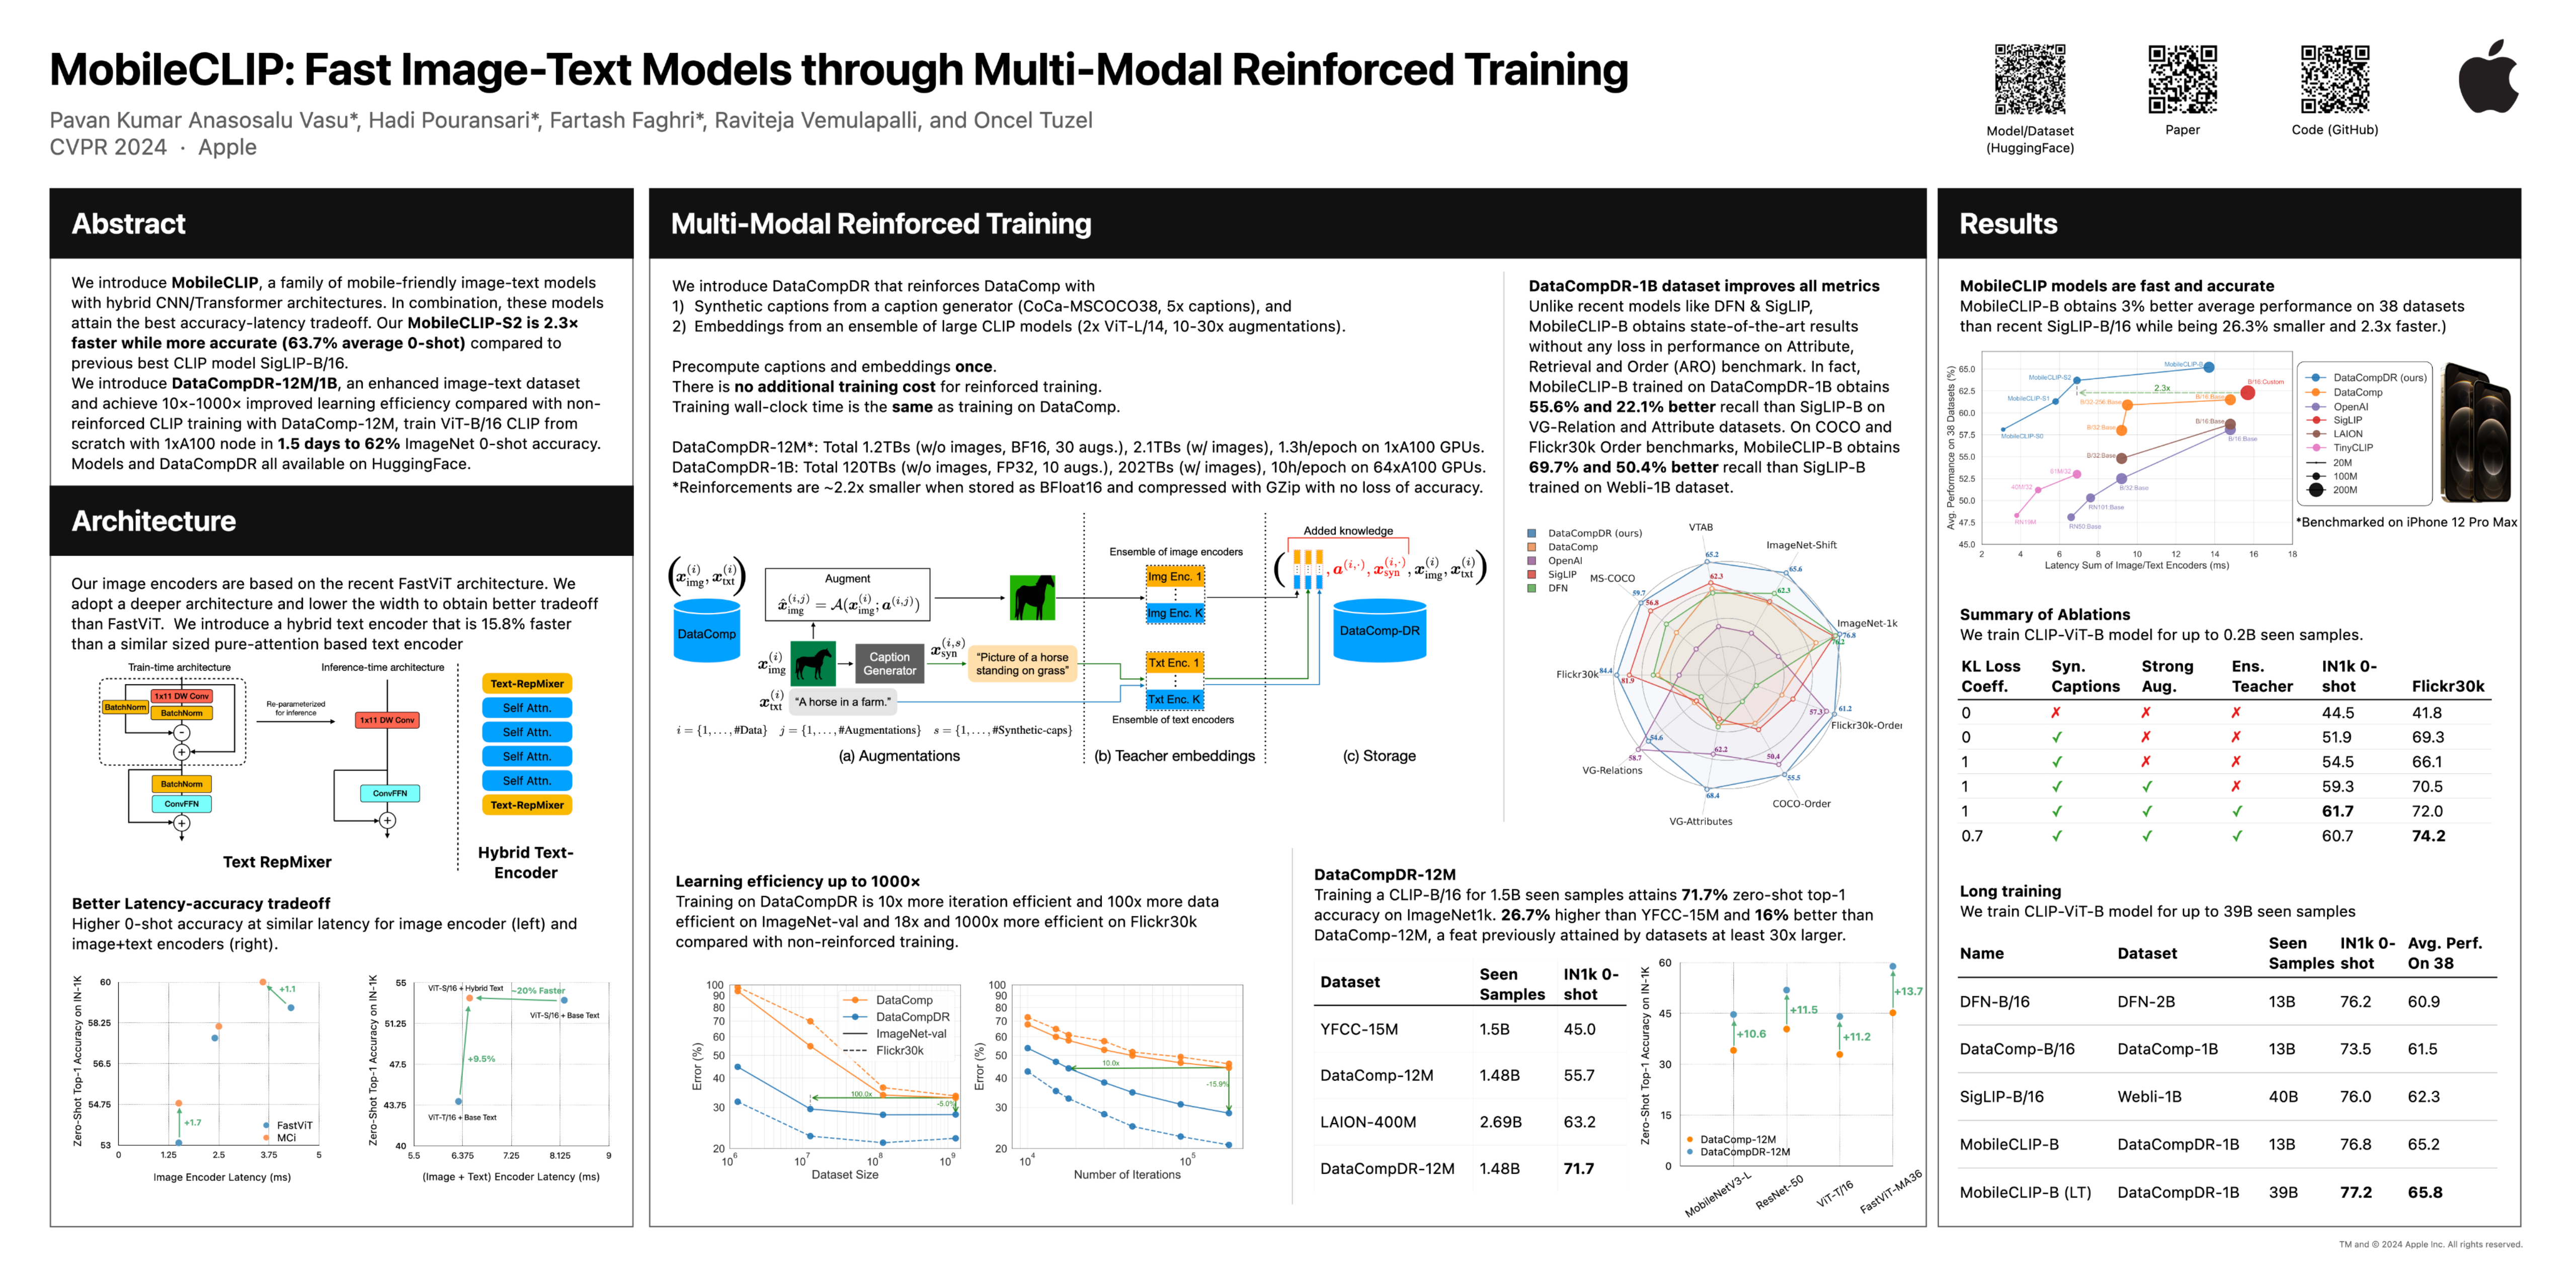 MobileCLIP: Fast Image-Text Models through Multi-Modal Reinforced Training
Pavan Kumar Anasosalu Vasu, Hadi Pouransari, Fartash Faghri, Raviteja Vemulapalli, Oncel Tuzel
[paper] [code] [demo]
Topic: Efficient and scalable vision
Session: Thu 20 Jun 8 p.m. EDT — 9:30 p.m. EDT #130
<br/>
<br/>
explainable computer vision
🔥 Describing Differences in Image Sets with Natural Language
Lisa Dunlap, Yuhui Zhang, Xiaohan Wang, Ruiqi Zhong, Trevor Darrell, Jacob Steinhardt, Joseph E. Gonzalez, Serena Yeung-Levy
[paper] [code]
Topic: Explainable computer vision
Session: Fri 21 Jun 8 p.m. EDT — 9:30 p.m. EDT #115
<br/>
<br/>
image and video synthesis and generation
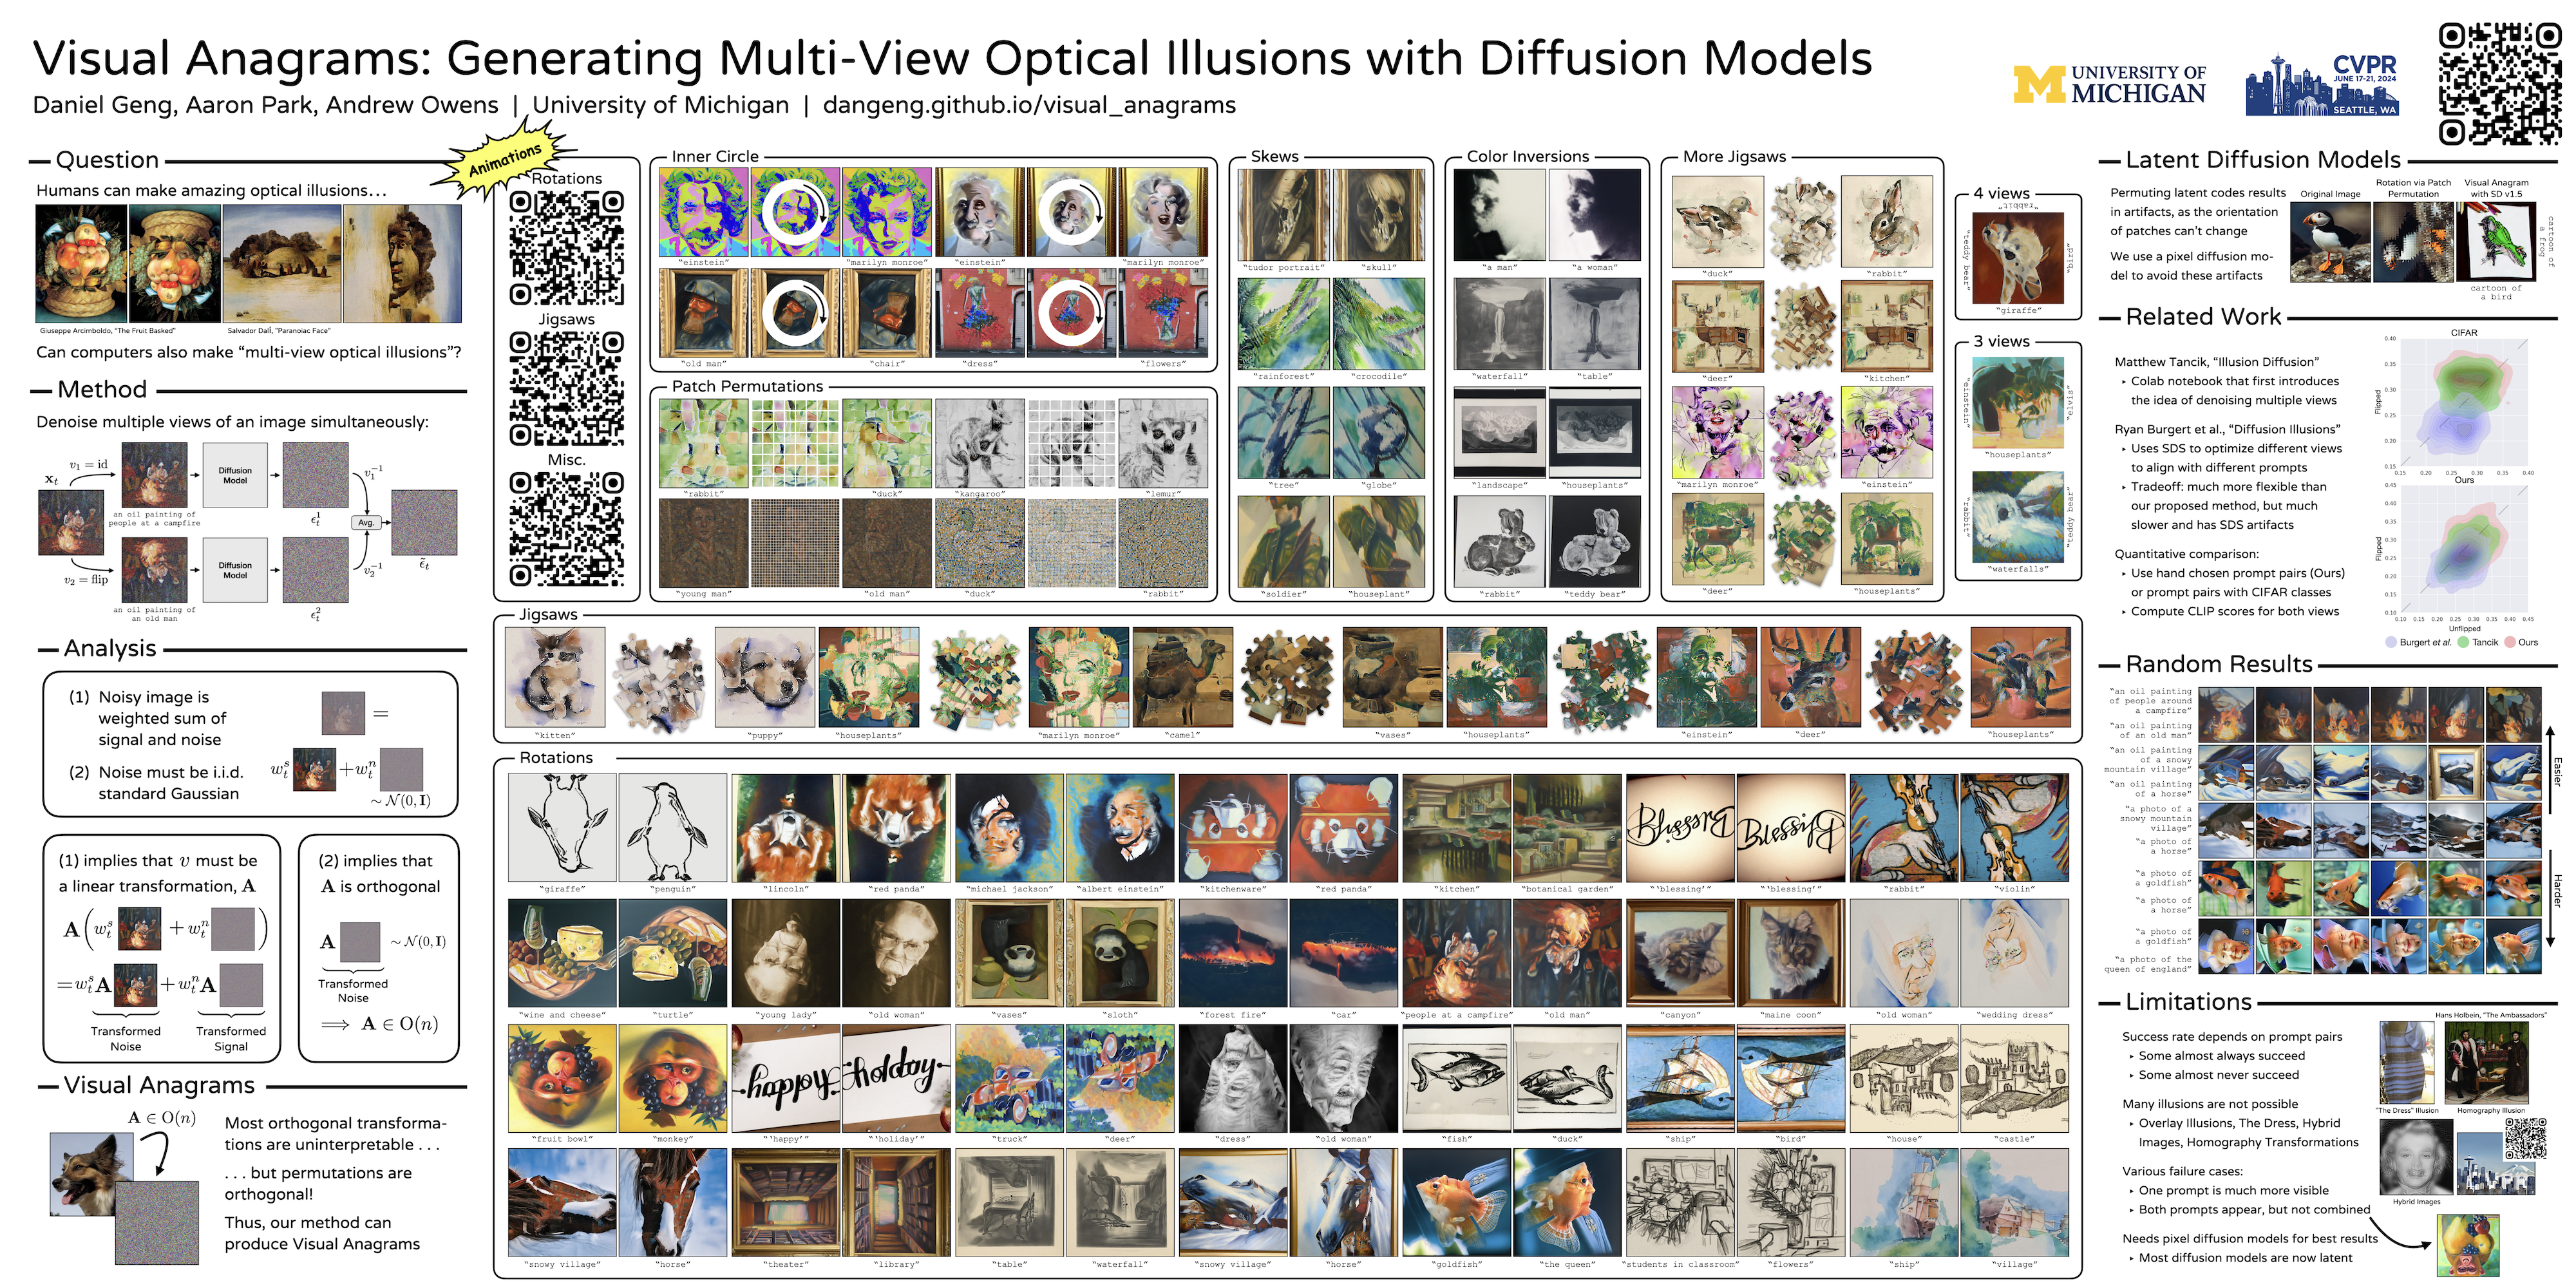
DemoFusion: Democratising High-Resolution Image Generation With No $$$ Ruoyi Du, Dongliang Chang, Timothy Hospedales, Yi-Zhe Song, Zhanyu Ma [paper] [code] [demo] [colab] Topic: Image and video synthesis and generation Session: Wed 19 Jun 8 p.m. EDT — 9:30 p.m. EDT #132
<br/>
🔥 DragDiffusion: Harnessing Diffusion Models for Interactive Point-based Image Editing
Yujun Shi, Chuhui Xue, Jun Hao Liew, Jiachun Pan, Hanshu Yan, Wenqing Zhang, Vincent Y. F. Tan, Song Bai
[paper] [code] [video]
Topic: Image and video synthesis and generation
Session: Wed 19 Jun 8 p.m. EDT — 9:30 p.m. EDT #392
<br/>
<br/>
<br/>
<br/>
low-level vision
XFeat: Accelerated Features for Lightweight Image Matching
Guilherme Potje, Felipe Cadar, Andre Araujo, Renato Martins, Erickson R. Nascimento
[paper] [code] [video] [demo] [colab]
Topic: Low-level vision
Session: Wed 19 Jun 1:30 p.m. EDT — 3 p.m. EDT #245
<br/>
<br/>
Robust Image Denoising through Adversarial Frequency Mixup
Donghun Ryou, Inju Ha, Hyewon Yoo, Dongwan Kim, Bohyung Han
[paper] [code] [video]
Topic: Low-level vision
Session: Wed 19 Jun 1:30 p.m. EDT — 3 p.m. EDT #250
<br/>
<br/>
multi-modal learning
🔥 Improved Baselines with Visual Instruction Tuning Haotian Liu, Chunyuan Li, Yuheng Li, Yong Jae Lee [paper] [code] Topic: Multi-modal learning Session: Fri 21 Jun 8 p.m. EDT — 9:30 p.m. EDT #209
<br/>
recognition: categorization, detection, retrieval
<br/>
<br/>
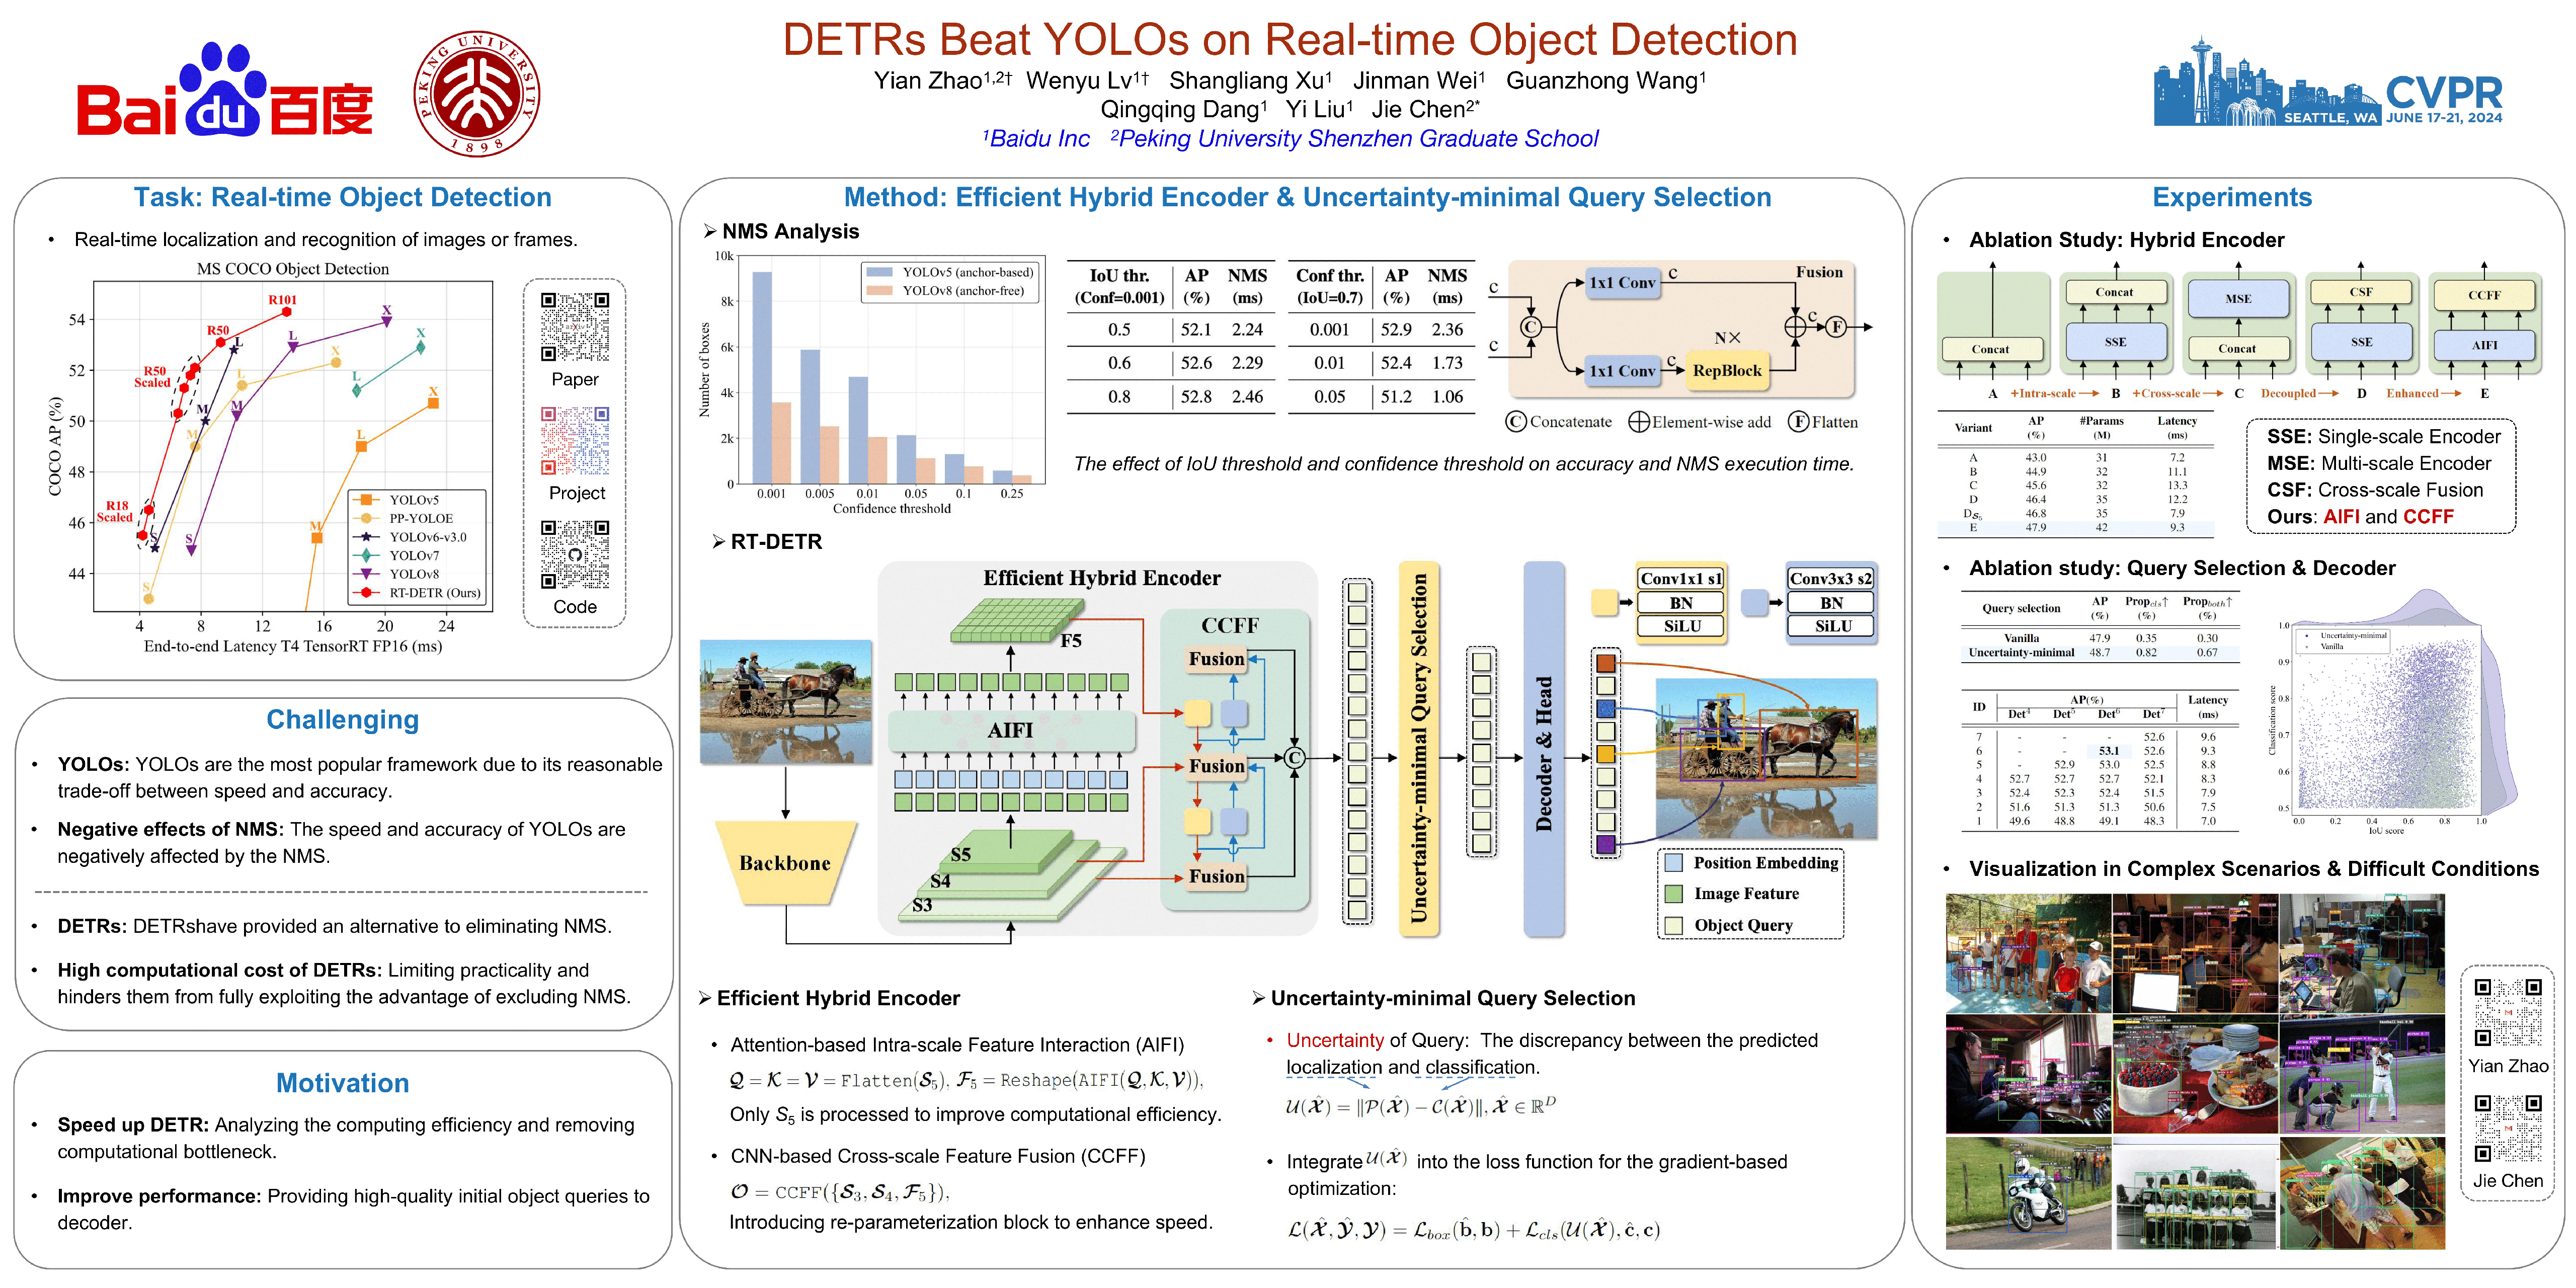
YOLO-World: Real-Time Open-Vocabulary Object Detection
Tianheng Cheng, Lin Song, Yixiao Ge, Wenyu Liu, Xinggang Wang, Ying Shan
[paper] [code] [video] [demo] [colab]
Topic: Recognition: Categorization, detection, retrieval
Session: Thu 20 Jun 8 p.m. EDT — 9:30 p.m. EDT #223
<br/>
<br/>
<br/>
<br/>
segmentation, grouping and shape analysis
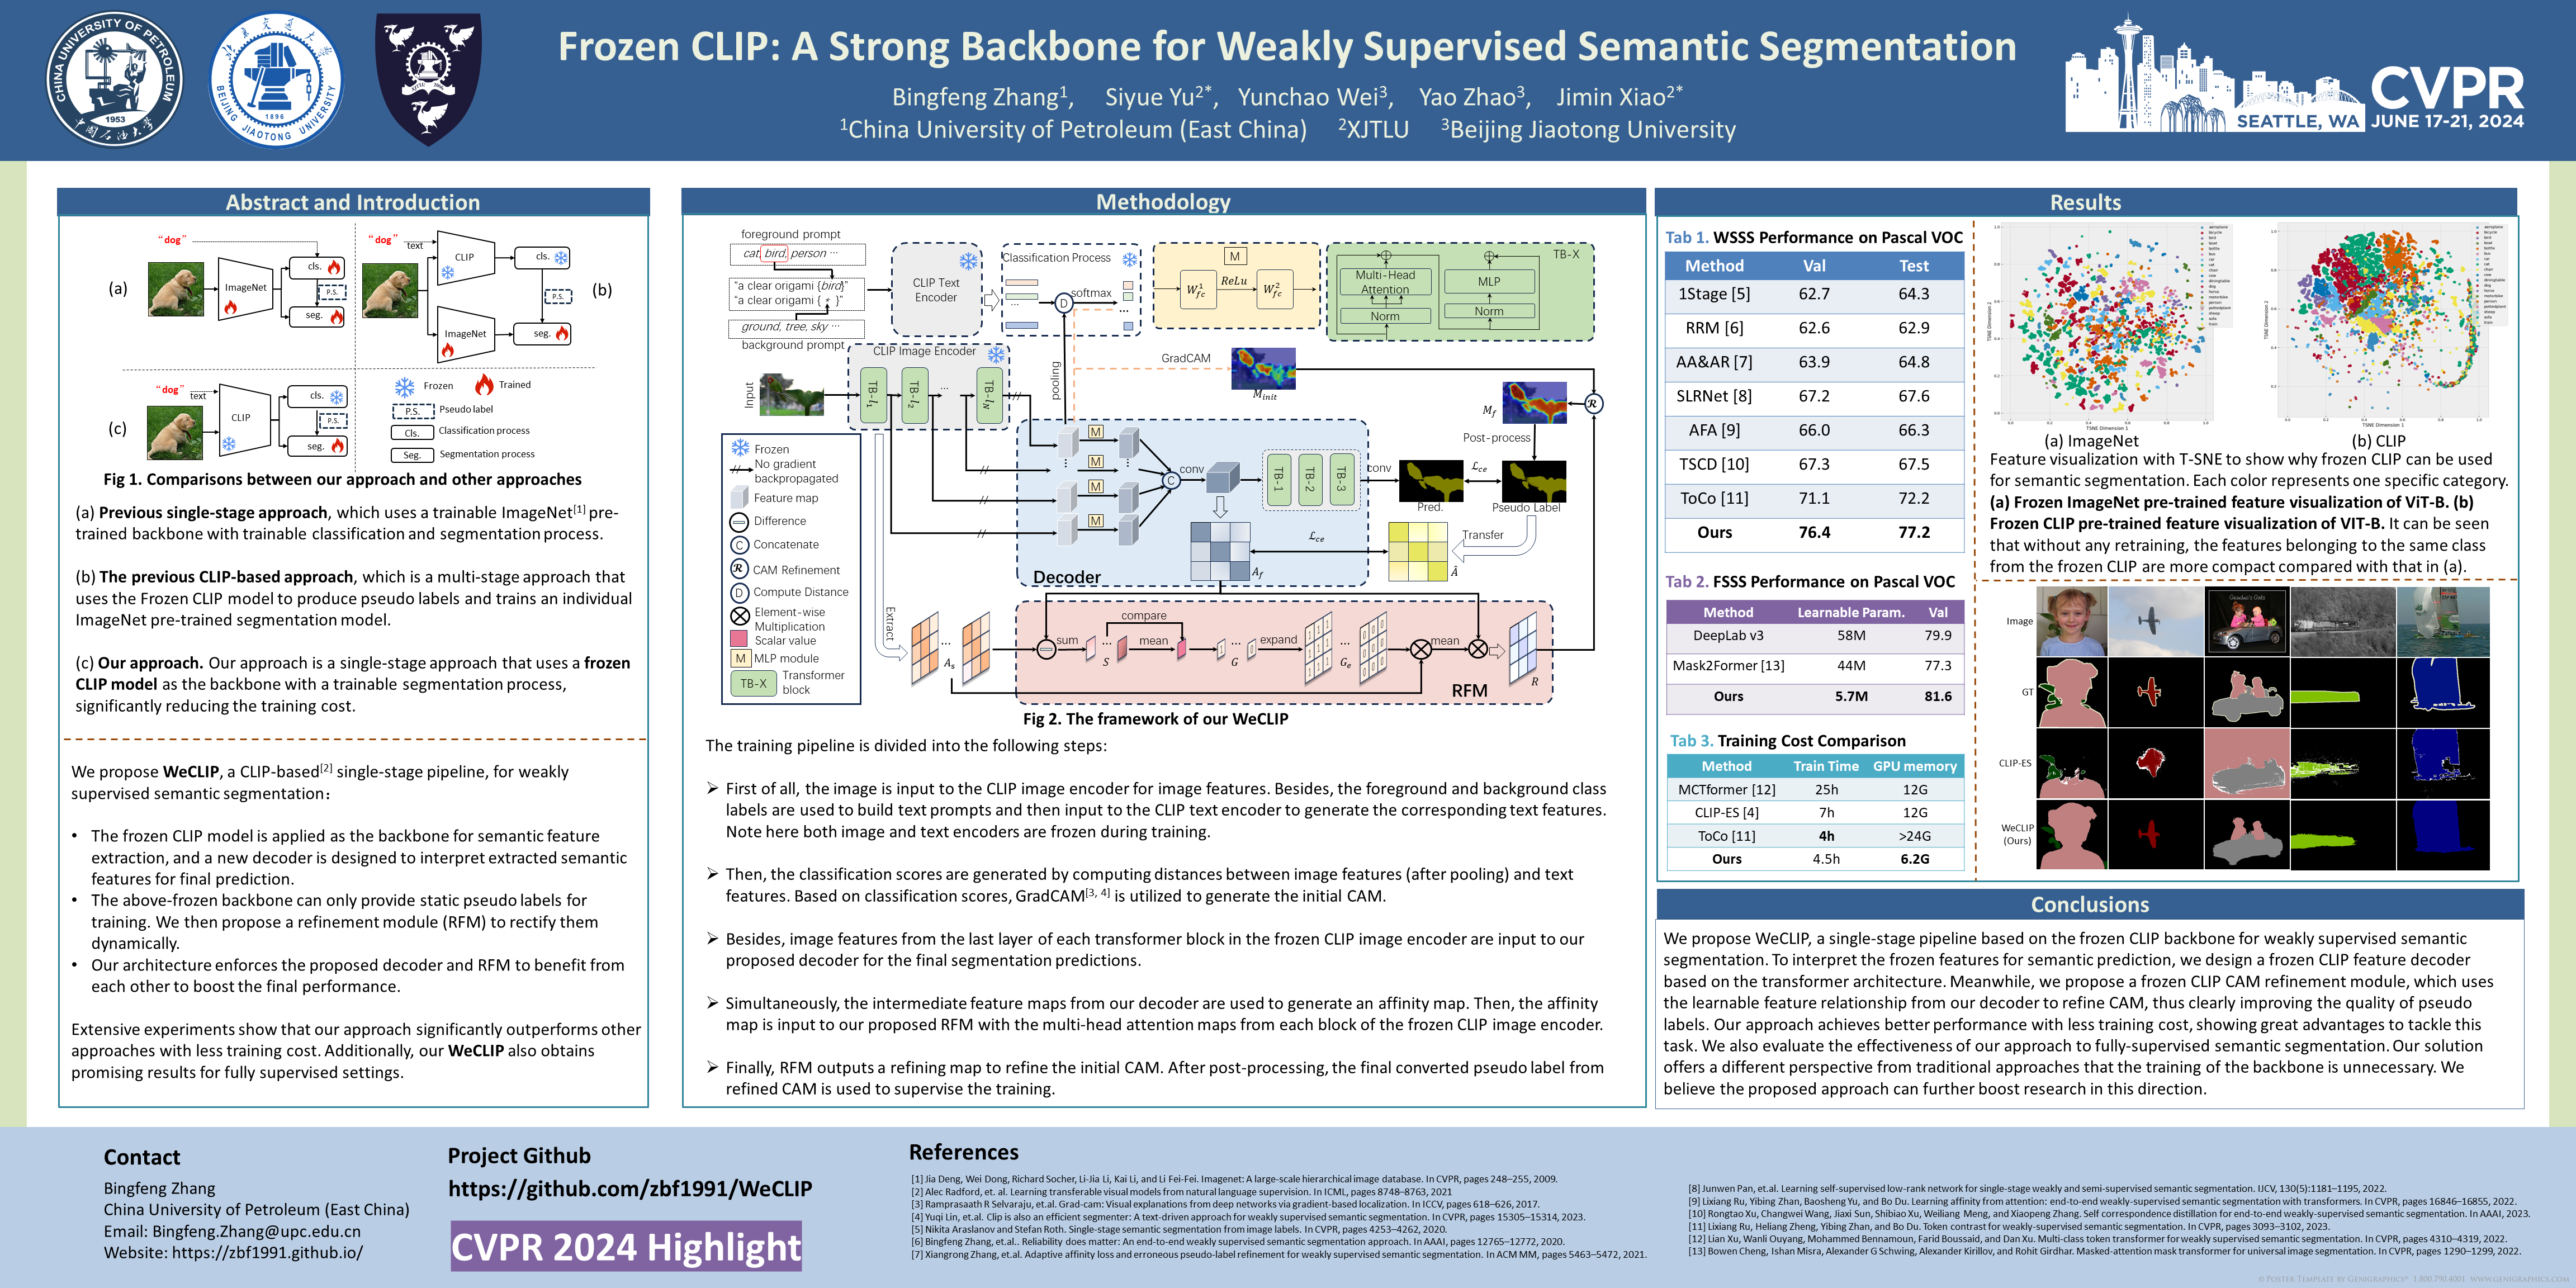
🔥 RobustSAM: Segment Anything Robustly on Degraded Images
Wei-Ting Chen, Yu-Jiet Vong, Sy-Yen Kuo, Sizhou Ma, Jian Wang
[paper] [video]
Topic: Segmentation, grouping and shape analysis
Session: Wed 19 Jun 1:30 p.m. EDT — 3 p.m. EDT #378
<br/>
<br/>
<br/>
<br/>
🔥 Semantic-aware SAM for Point-Prompted Instance Segmentation
Zhaoyang Wei, Pengfei Chen, Xuehui Yu, Guorong Li, Jianbin Jiao, Zhenjun Han
[paper] [code] [video]
Topic: Segmentation, grouping and shape analysis
Session: Wed 19 Jun 1:30 p.m. EDT — 3 p.m. EDT #331
<br/>
<br/>
🔥 In-Context Matting He Guo, Zixuan Ye, Zhiguo Cao, Hao Lu [paper] [code] Topic: Segmentation, grouping and shape analysis Session: Wed 19 Jun 1:30 p.m. EDT — 3 p.m. EDT #343
<br/>
🔥 General Object Foundation Model for Images and Videos at Scale
Junfeng Wu, Yi Jiang, Qihao Liu, Zehuan Yuan, Xiang Bai, Song Bai
[paper] [code] [video]
Topic: Segmentation, grouping and shape analysis
Session: Wed 19 Jun 1:30 p.m. EDT — 3 p.m. EDT #350
<br/>
<br/>
self-supervised or unsupervised representation learning
<br/>
<br/>
video: low-level analysis, motion, and tracking
<br/>
<br/>
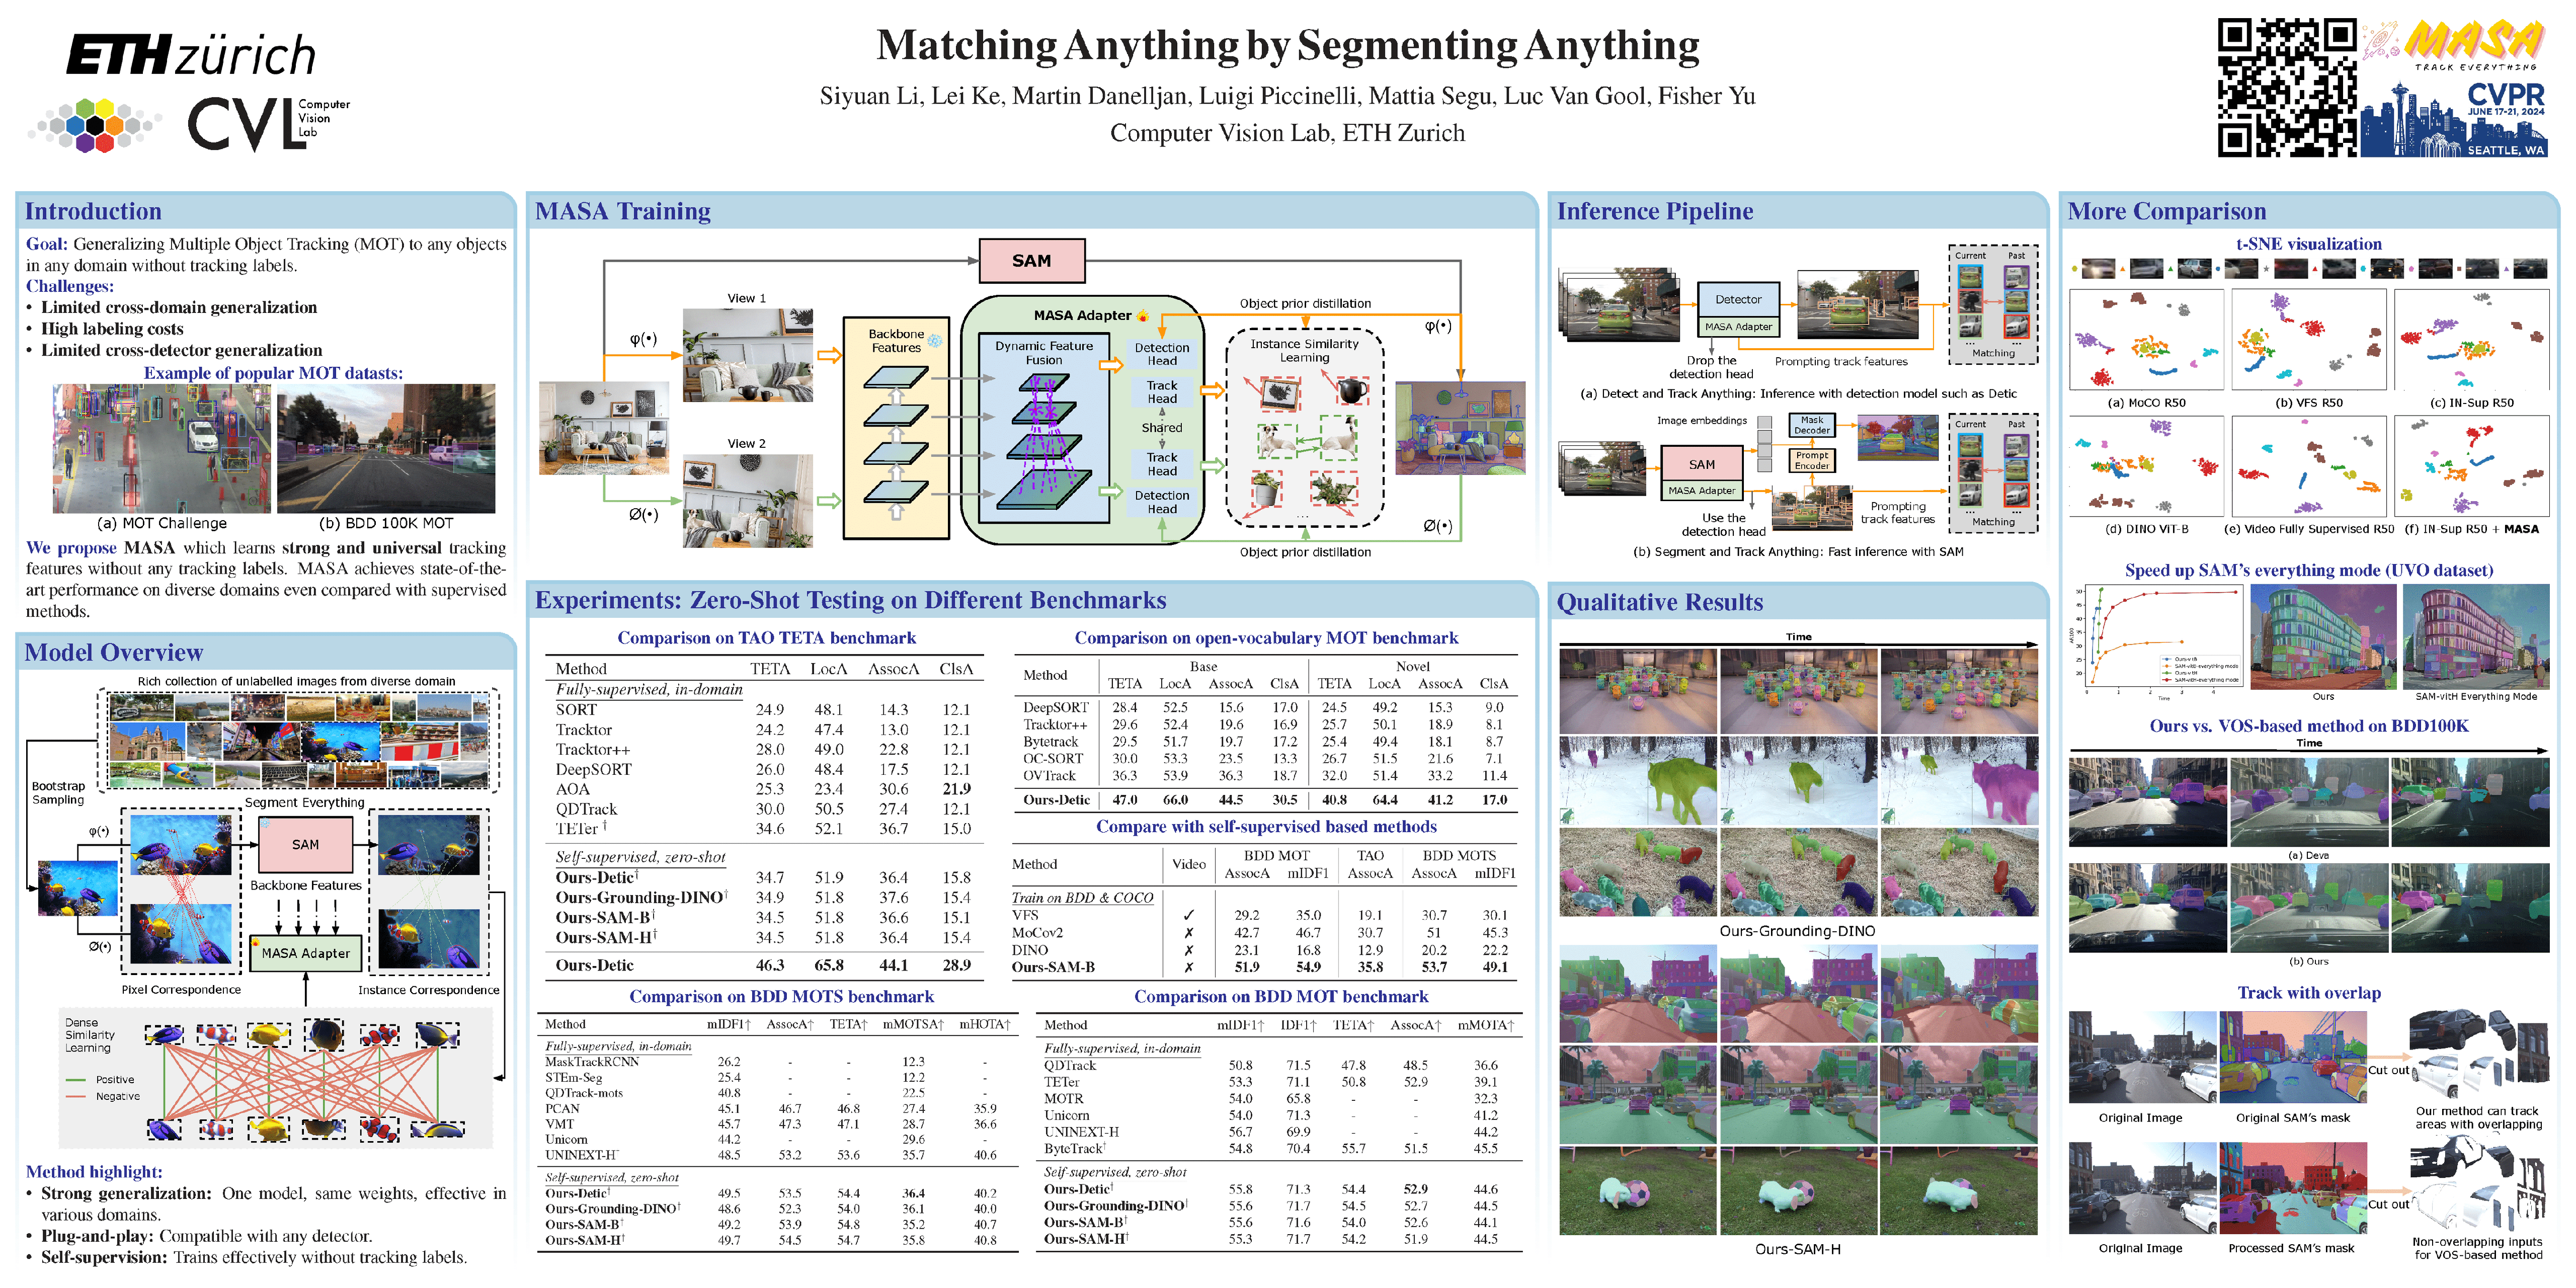
DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction
Weiyi Lv, Yuhang Huang, Ning Zhang, Ruei-Sung Lin, Mei Han, Dan Zeng
[paper] [code]
Topic: Video: Low-level analysis, motion, and tracking
Session: Thu 20 Jun 8 p.m. EDT — 9:30 p.m. EDT #455
<br/>
<br/>
vision, language, and reasoning
<br/>
<br/>
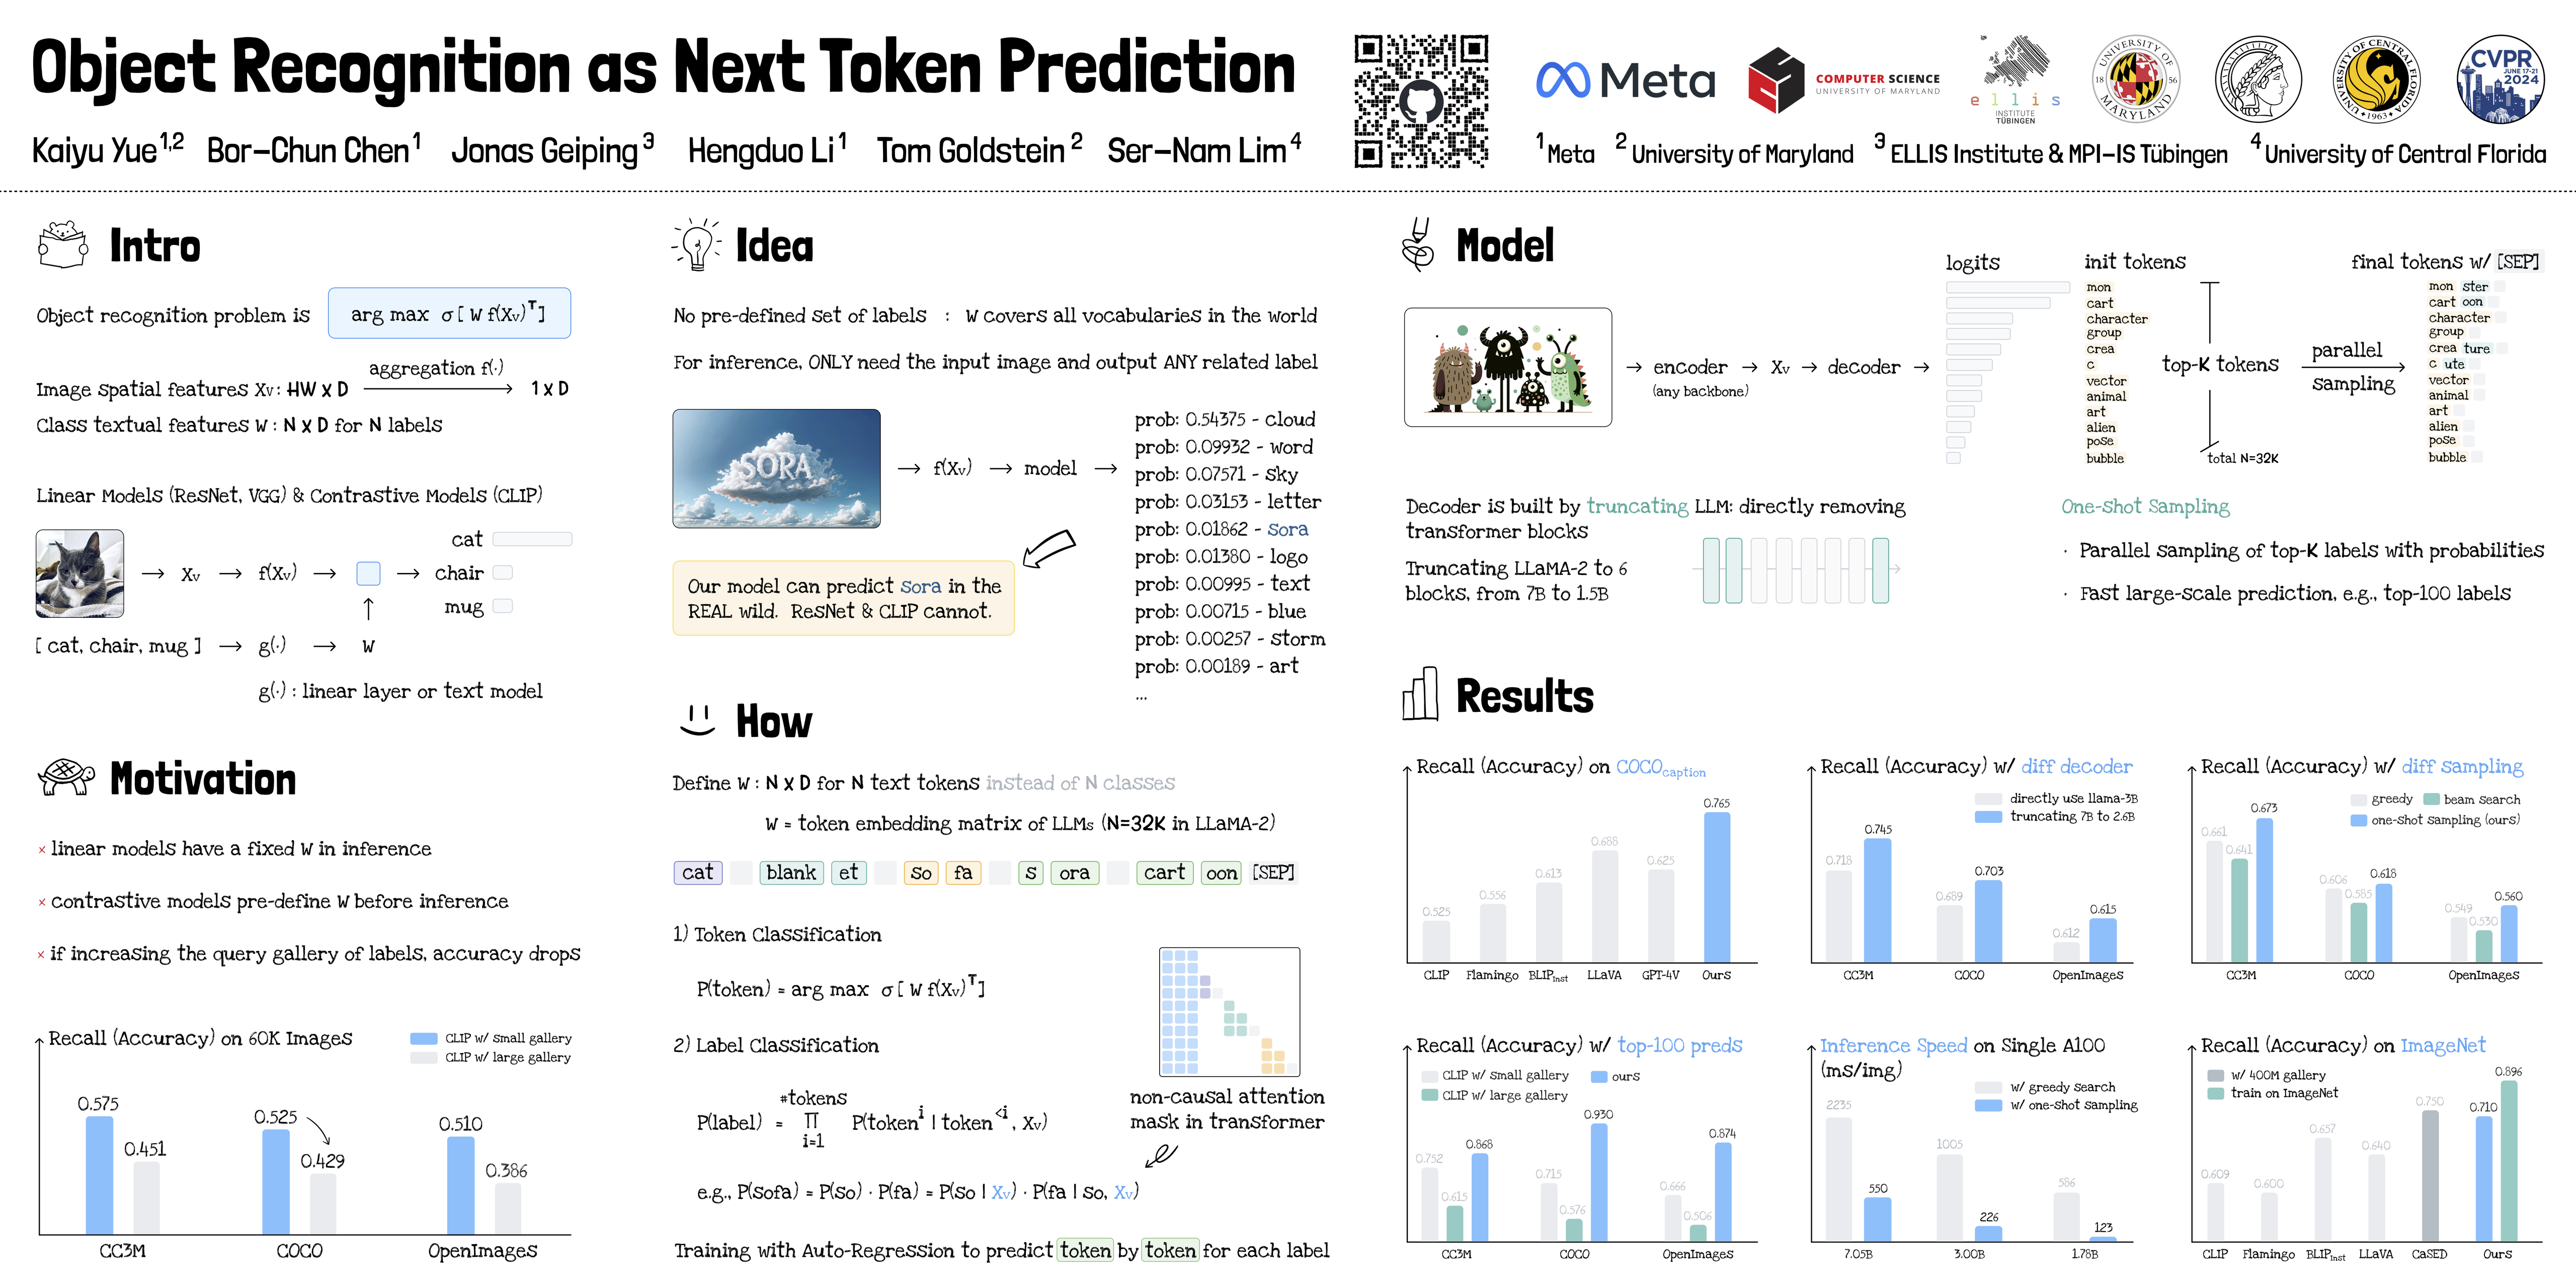
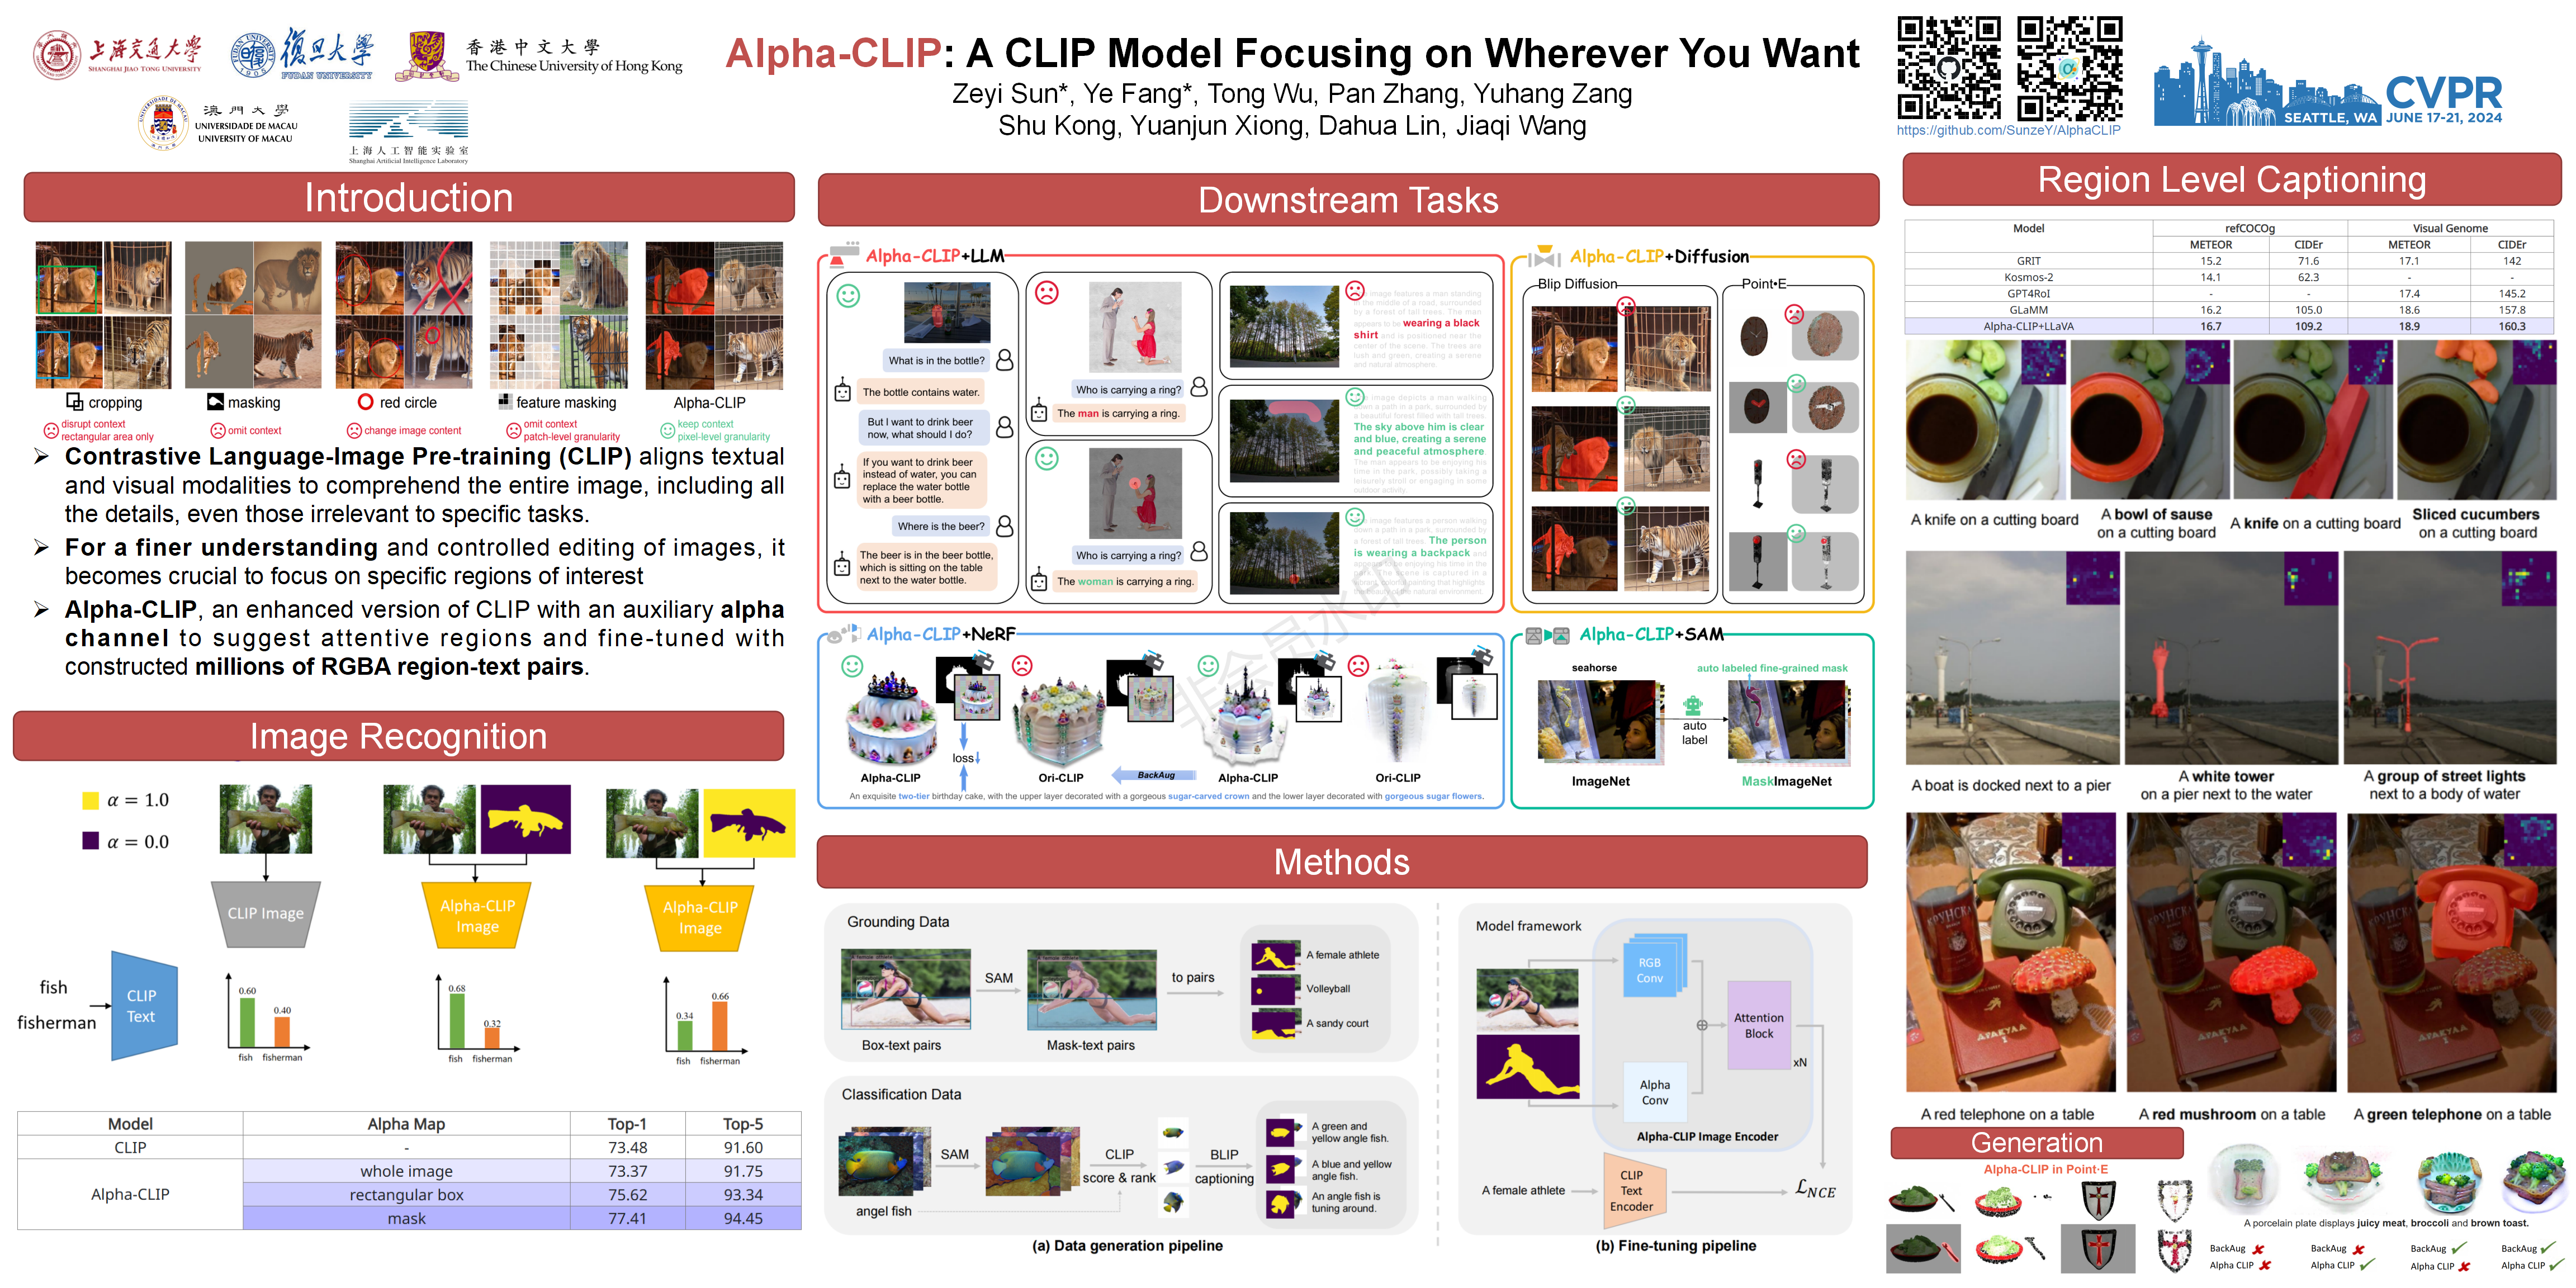
🔥 Eyes Wide Shut? Exploring the Visual Shortcomings of Multimodal LLMs Shengbang Tong, Zhuang Liu, Yuexiang Zhai, Yi Ma, Yann LeCun, Saining Xie [paper] [code] Topic: Vision, language, and reasoning Session: Thu 20 Jun 1:30 p.m. EDT — 3 p.m. EDT #390
<br/>
<br/>
<br/>
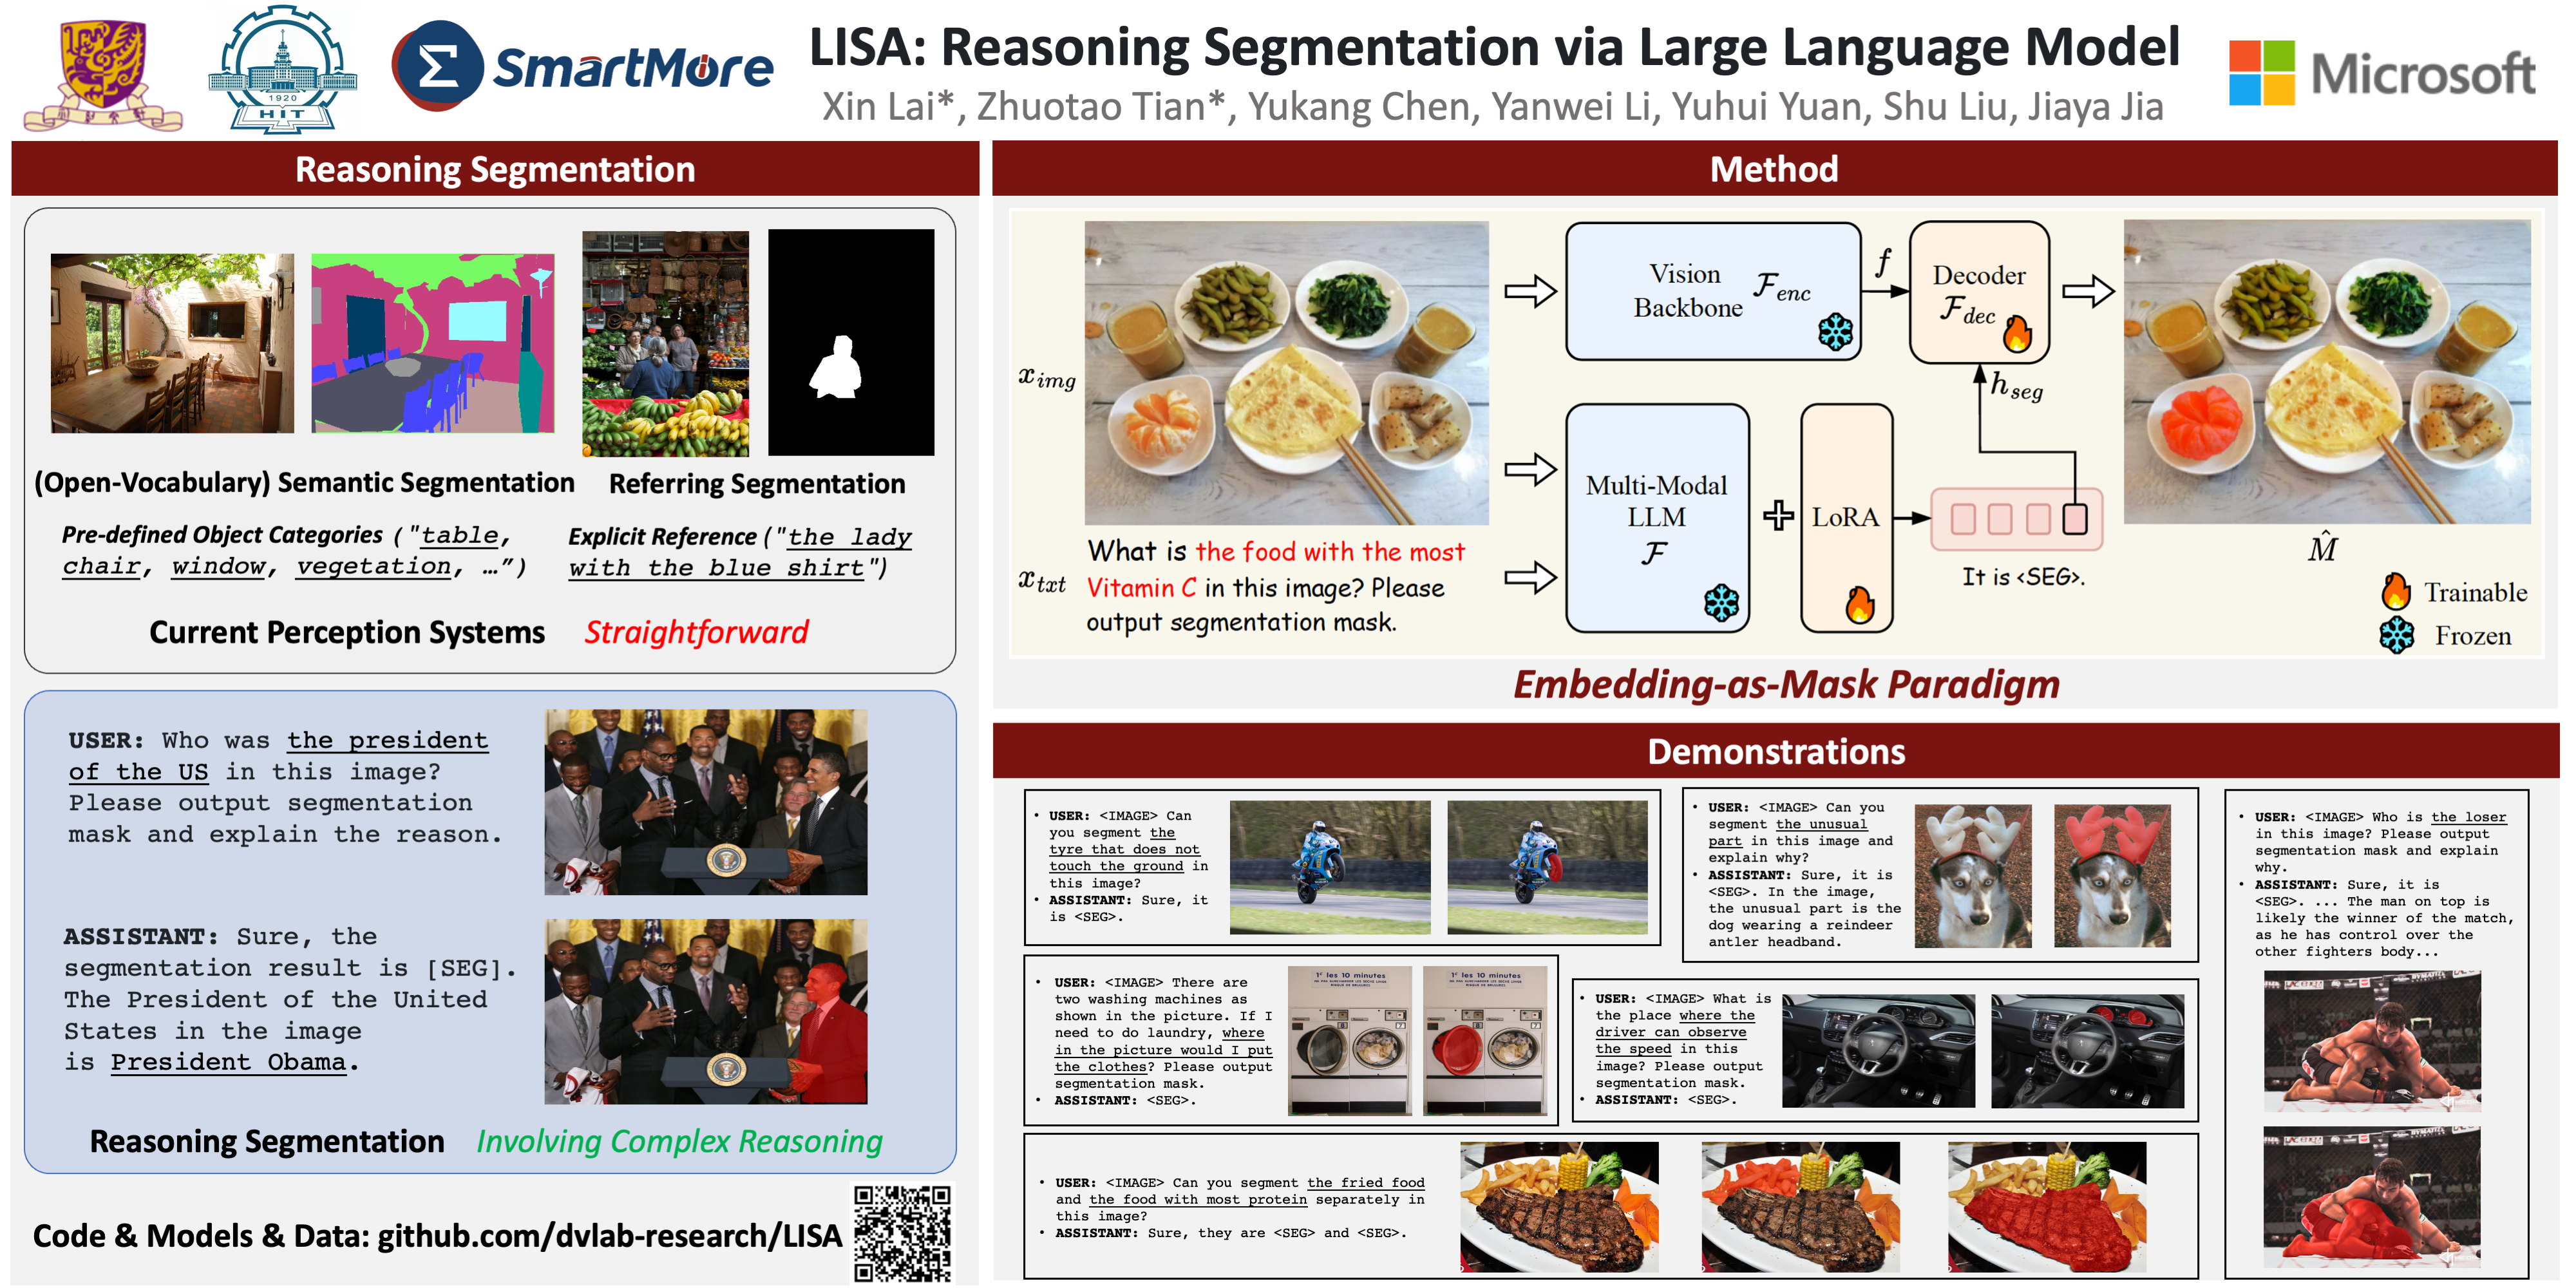
ViP-LLaVA: Making Large Multimodal Models Understand Arbitrary Visual Prompts
Mu Cai, Haotian Liu, Dennis Park, Siva Karthik Mustikovela, Gregory P. Meyer, Yuning Chai, Yong Jae Lee
[paper] [code] [video] [demo]
Topic: Vision, language, and reasoning
Session: Thu 20 Jun 1:30 p.m. EDT — 3 p.m. EDT #317
<br/>
<br/>
<br/>
<br/>
🦸 contribution
We would love your help in making this repository even better! If you know of an amazing
paper that isn't listed here, or if you have any suggestions for improvement, feel free
to open an
issue
or submit a
pull request.