

- 評価軸
- スコア
- 正確性
- 4.5/5
- 簡潔さ
- 5/5
- 日本語の自然さ
- 4/5
Specs
- 評価軸スコア
- 正確性4.5/5
- 簡潔さ5/5
- 日本語の自然さ4/5
- キーワード抽出5/5
- 評価軸最優秀
- 内容の正確性Qwopus3.5-9B
- 簡潔さqwen3:8b / qwen3:14b
- 日本語の自然さgemma3:12b
- 速度と品質のバランスBonsai-8B
- コストパフォーマンスBonsai-8B
- 8GB VRAM最適Qwopus3.5-9B
- Ollama対応qwen3:8b
- 用途推奨モデル
- 高精度が必要高精度が必要
- 速度重視速度重視
- バランス型バランス型
- 8GB VRAM8GB VRAM
- Model速度
- gemma4:e2b157 tok/s
- gemma4:e4b109 tok/s
- Model速度
- gemma4:e2b157 tok/s
- gemma4:e4b113 tok/s
- 項目値
- ModelModel
- HardwareHardware
- ResolutionResolution
- Inference StepsInference Steps
- Average TimeAverage Time
- 項目値
- HardwareHardware
- ModelModel
- QuantizationQuantization
- QEPQEP
- Output SizeOutput Size
- StatusStatus
- 項目値
- HardwareHardware
- ModelModel
README
Japanese LLM Benchmark
A benchmark tool for evaluating Japanese language capabilities of various LLMs.
目次 (Table of Contents)
- Benchmark Results - 総合ランキング
- 定性的評価 - S+/S/A/B/C/D Tier詳細
- RTX 5060 (8GB) ベンチマーク
- キーワード抽出ベンチマーク
- Gemma 4 ベンチマーク
- VLM (Vision Language Model) ベンチマーク
- OneCompression 量子化テスト
- Quansloth TurboQuant コンテキスト拡張
- Needle-in-Haystack ベンチマーク
- RotorQuant KVキャッシュ圧縮ベンチマーク - NEW!
- 大規模モデル(A100)テスト
Features
- ROUGE Score Evaluation: Measures summarization quality using ROUGE-1, ROUGE-2, and ROUGE-L
- Speed Benchmarking: Measures tokens per second for each model
- WebUI: Interactive web interface for running benchmarks and visualizing results
- Multiple Model Support: Works with any Ollama-compatible model
Requirements
- Python 3.10+
- Ollama running locally
- 8GB+ VRAM (for full GPU inference)
Installation
pip install -r requirements.txtUsage
WebUI Mode
python app.pyAccess the WebUI at http://localhost:8080
CLI Mode
python benchmark.py --dataset dataset.jsonl --models nemotron-3-nano:4b qwen3:4b --samples 10Dataset Format
JSONL file with the following structure:
{"text": "Long Japanese text to summarize...", "summary": "Reference summary"}Benchmark Results
RTX 5090 (32GB) / RTX 5060 (8GB) - 7000文字長文テキスト - 定性的評価
総合ランキング
| Rank | Model | ROUGE-L | Speed | Size | Tier |
|---|---|---|---|---|---|
| 🥇 | Qwopus3.5-9B ⚠️ | 0.533 | 196 tok/s | 5.4GB | S+ |
| 🥈 | qwen3:235b-a22b | 0.518 | 35 tok/s | 142GB | S+ |
| 🆕 | Qwen3.5-9B (公式) | 0.492 | 197 tok/s (5090) | 5.4GB | S+ |
| 🆕 | gemma4-31B-Opus ⚠️ | 0.401 | 27.8 tok/s | 18.7GB | A |
| 🆕 | OmniCoder-9B ⚠️ | 0.382 | 195 tok/s | 5.4GB | A |
| 🆕 | Bonsai-8B | 0.400 | 325 tok/s | 1.2GB | A |
| 1 | qwen3:30b-a3b | 0.347 | 200 tok/s | 18.6GB | S |
| 2 | qwen3:8b | 0.333 | 204 tok/s | 5.2GB | S |
| 3 | gemma4:e4b | 0.32* | 109 tok/s | 9.6GB | A |
| 4 | gemma4:e2b | 0.30* | 157 tok/s | 7.2GB | A |
| 5 | gemma3:12b | 0.303 | 141 tok/s | 8.1GB | A |
| 4 | qwen3-128k | 0.302 | 203 tok/s | 5.2GB | A |
| 5 | qwen3:14b | 0.292 | 128 tok/s | 9.3GB | A |
| 6 | gpt-oss-128k | 0.288 | 259 tok/s | 13.8GB | A |
| 7 | mistral-small | 0.285 | 96 tok/s | 14.3GB | A |
| 8 | SmallThinker-21BA3B | 0.268 | 256 tok/s | 13GB | B |
| 9 | ELYZA 8B | 0.258 | 241 tok/s | 4.9GB | B |
| 10 | llama3.2:3b | 0.246 | 427 tok/s | 2.0GB | B |
| 11 | gemma3:4b | 0.243 | 286 tok/s | 3.3GB | B |
| 12 | mistral:7b | 0.196 | 244 tok/s | 4.4GB | C |
| 13 | LLM-JP 1.8b | 0.150 | 609 tok/s | 1.2GB | D |
| 14 | phi4-mini | 0.107 | 378 tok/s | 2.5GB | D |
| 15 | nemotron-mini | 0.048 | 366 tok/s | 2.7GB | D |
定性的評価
S+ Tier - 最高品質
Qwopus3.5-9B-v3 (NEW!) - RTX 5090 / A100
- ROUGE-L: 0.533 | Speed: 196 tok/s (5090) / 108 tok/s (A100) | Size: 5.4GB
⚠️ ライセンス上の懸念: このモデルは「Claude Opusの構造化推論習慣を蒸留」して訓練されたと明記されています。Anthropicの利用規約では、Claude出力を使用して汎用チャットボットや競合AIモデルを訓練することを禁止しています。商用利用の際はライセンスリスクにご注意ください。
生成例:
大規模言語モデルとAgenticAIは、デジタルツインや自律的行動など新たな応用をもたらす。技術主導から人間性・倫理・市民参加を重視する情報エコシステムへ。印刷革命に続くデジタル革命で、市民が情報の創造・検証に参加する双方向性が重要。AI倫理や多様な価値観の対話、学際的視点による新たなルール作りが、未来社会の構築に不可欠だ。
評価:
- ✅ ROUGE-L 0.533で最高精度(qwen3:235bを超える!)
- ✅ 詳細なThinking過程を出力(英語)
- ✅ 5.4GBで8GB VRAMでも動作可能
- ✅ RTX 5090で196 tok/sの高速推論
- ⚠️ llama.cpp必須(Ollamaは非対応)
- ⚠️ Claude蒸留によるライセンスリスク(商用利用注意)
動作方法:
# llama.cpp をビルド
git clone https://github.com/ggml-org/llama.cpp && cd llama.cpp
cmake -B build -DGGML_CUDA=ON && cmake --build build --target llama-cli -j8

# モデルをダウンロード
curl -L -o Qwen3.5-9B.Q4_K_M.gguf \
  "https://huggingface.co/Jackrong/Qwopus3.5-9B-v3-GGUF/resolve/main/Qwen3.5-9B.Q4_K_M.gguf"

# 推論実行
./build/bin/llama-cli -m Qwen3.5-9B.Q4_K_M.gguf -p "要約してください..." -ngl 99
qwen3:235b-a22b (MoE) - A100 80GB x8
- ROUGE-L: 0.518 | Speed: 35 tok/s | Size: 142GB
生成例:
要約: LLMの進化で、ユーザーに最適化されたパーソナルAIが加速。汎用モデルから目的・ユーザー別モデルへ移行し、AgenticAIはメール返信や意思決定を担う。技術戦略では人間性や倫理が重要視され、欧州はプライバシー、北米は市場主導のAI倫理アプローチが対比される。
評価:
- ✅ ROUGE-L 0.518で高精度
- ✅ 詳細なThinking過程を出力
- ✅ 要約品質が非常に高い
- ⚠️ 142GB VRAMが必要(8x A100 80GB)
- ⚠️ 速度は35 tok/sと遅め
Qwen3.5-9B (公式モデル) - RTX 5090 / V100
- ROUGE-L: 0.492 (Q8_0) / 0.371 (Q4_K_M) | Speed: 197 tok/s (5090) / 59.5 tok/s (V100) | Size: 5.4GB (Q4_K_M) / 9.5GB (Q8_0)
生成例:
デジタル技術、特に AI の急速な発展は社会に大きな変化をもたらしています。自然言語処理や画像認識など、人間に匹敵する性能を発揮するようになり、医療や交通など多方面で恩恵をもたらしています。一方で、プライバシー侵害や雇用問題、AI 判断の不透明性といった課題も浮上しています。今後、これらの技術を賢明に活用し、負の影響を最小化しながら持続可能な社会を築くことが求められています。
Thinking過程(英語):
The user wants me to summarize the given Japanese text into approximately 200 characters. Let me first analyze the original text: 1. Digital technology development bringing big changes... 2. AI progress is remarkable... 3. This innovation has both positive and negative aspects...
評価:
- ✅ 公式Qwen3.5-9Bモデル(ライセンス面でクリーン)
- ✅ 英語でのThinking過程を出力(構造的な分析)
- ✅ 要約品質が高い(原文の要点を的確に抽出)
- ✅ 文章が自然で読みやすい
- ⚠️ Q8_0で9.5GB(16GB以上のVRAM推奨)
- ⚠️ V100で59.5 tok/s(RTX 5090ならより高速)
動作方法:
# HuggingFaceからGGUFをダウンロード
curl -L -o Qwen3.5-9B.Q8_0.gguf \
  "https://huggingface.co/lmstudio-community/Qwen3.5-9B-GGUF/resolve/main/Qwen3.5-9B-Q8_0.gguf"

# 推論実行
./build/bin/llama-cli -m Qwen3.5-9B.Q8_0.gguf -p "要約してください..." -ngl 99
S Tier - 卓越した品質(実用レベルで推奨)
qwen3:30b-a3b (MoE)
- ROUGE-L: 0.347 | Speed: 200 tok/s | Size: 18.6GB
生成例 (Sample 1):
大規模言語モデルは目的別・ユーザー別にカスタマイズされ、多様性を持つべきという考え方が広がっている。AgenticAIがユーザーの好みを学習し、デジタルツインとしてメール返信や意思決定を担う未来が描かれる。技術主導型の未来戦略において、人間性や倫理、市民参加が不可欠と認識が拡大。欧州はプライバシー保護を最優先に、北米は市場主導型のアプローチを取るなど、地域ごとのAI倫理のアプローチが異なる。
評価:
- ✅ 主要論点を網羅(LLM、デジタルツイン、倫理、国際協調)
- ✅ 「欧州 vs 北米」の具体的対比を保持
- ✅ 日本語として自然で読みやすい
qwen3:8b
- ROUGE-L: 0.333 | Speed: 204 tok/s | Size: 5.2GB
生成例 (Sample 1):
大規模言語モデルの応用が注目され、ユーザー別カスタマイズやデジタルツインとしてのAgenticAIの可能性が示される。AI倫理や市民参加の重要性が強調され、欧米アジアの地域差も。技術と人間性の融合が未来の情報エコシステムの基盤となる。
評価:
- ✅ 117文字で非常に簡潔
- ✅ 核心的キーワードを的確に抽出
- ✅ 8GB VRAMで動作可能
- ⚠️ 一部文末が唐突
A Tier - 高品質(多くの用途で推奨)
gemma4-31B-Opus (NEW!) - A100 80GB
- ROUGE-L: 0.401 | Speed: 27.8 tok/s | Size: 18.7GB (Q4_K_M)
⚠️ ライセンス上の懸念: このモデルは「Claude Opus 4.6の推論トレース」で訓練されたと明記されています。Qwopusと同様のライセンスリスクにご注意ください。
生成例 (Sample 0):
大規模言語モデルの進化により、個人の思考パターンを学習したAIが業務を代行するデジタルツインの実現が期待されています。一方で、情報の信頼性や透明性、プライバシー保護といった倫理的課題も浮き彫りとなっています。欧米とアジアで規制アプローチが異なる中、国際的な標準策定には多角的な協議が不可欠です。
評価:
- ✅ Gemma 4ベースの31Bパラメータモデル
- ✅ 高品質な日本語要約を生成
- ✅ 詳細な内容を適切な長さでまとめる
- ⚠️ 18.7GB VRAMが必要(A100推奨)
- ⚠️ 速度は27.8 tok/sと低め
- ⚠️ Claude Opus 4.6蒸留によるライセンスリスク
動作方法:
# モデルをダウンロード (18.7GB)
wget -O gemma4-31B-opus.q4_k_m.gguf \
  "https://huggingface.co/TeichAI/gemma-4-31B-it-Claude-Opus-Distill-GGUF/resolve/main/gemma-4-31B-it-Claude-Opus-Distill.q4_k_m.gguf"

# llama-server で起動
./build/bin/llama-server -m gemma4-31B-opus.q4_k_m.gguf \
  -c 32768 -ngl 99 --host 0.0.0.0 --port 8080
Bonsai-8B (NEW!) - 1-bit Quantization
- ROUGE-L: 0.400 | Speed: 325 tok/s | Size: 1.16GB
生成例:
大規模言語モデルは、技術主導型の未来戦略に人間性や倫理が不可欠であると認識されています。AgenticAIは、長期間の対話を通じてユーザーの好みを学習し、代わりに行動する可能性があります。情報エコシステムでは、多様な視点や文化が融合し、市民の参加が促進されています。
評価:
- ✅ 1-bit量子化で1.16GB(超軽量!)
- ✅ 325 tok/sの超高速推論
- ✅ 8Bパラメータの品質を維持
- ⚠️ PrismML版llama.cpp必須
動作方法:
# PrismML版 llama.cpp をビルド(1-bit対応)
git clone https://github.com/PrismML-Eng/llama.cpp && cd llama.cpp
cmake -B build -DGGML_CUDA=ON && cmake --build build -j8

# モデルをダウンロード
curl -L -o Bonsai-8B.gguf \
  "https://huggingface.co/prism-ml/Bonsai-8B-gguf/resolve/main/Bonsai-8B.gguf"

# 推論実行
./build/bin/llama-cli -m Bonsai-8B.gguf -p "..." -ngl 99 --temp 0.5
OmniCoder-9B (NEW!) - RTX 5090
- ROUGE-L: 0.382 | Speed: 195 tok/s | Size: 5.4GB (Q4_K_M)
⚠️ ライセンス上の懸念: このモデルは「Claude Opus 4.6のコーディング推論トレース」で訓練されたと明記されています。Qwopusと同様のライセンスリスクにご注意ください。
生成例:
大規模言語モデルの応用は注目すべきです。さらに、目的やユーザー別にカスタマイズされ、多様性を持つべきという考え方もあります。AgenticAI は長期間にわたってユーザーと対話し、好みや思考パターンを学習し続けます。その結果、ある意味でユーザーのデジタルツインとなり、忙しい時にメールの返信や会議への出席、意思決定を代行する未来が訪れると想像されます。
評価:
- ✅ Qwen3.5-9Bベースのコーディング特化モデル
- ✅ 英語でのThinking過程を出力
- ✅ Apache 2.0ライセンス(ただしClaude蒸留の懸念)
- ⚠️ 要約タスクでは公式Qwen3.5-9Bと同等の性能
- ⚠️ Claude Opus 4.6蒸留によるライセンスリスク
動作方法:
# モデルをダウンロード
curl -L -o omnicoder-9b-q4_k_m.gguf \
  "https://huggingface.co/Tesslate/OmniCoder-9B-GGUF/resolve/main/omnicoder-9b-q4_k_m.gguf"

# 推論実行
./build/bin/llama-cli -m omnicoder-9b-q4_k_m.gguf -p "要約してください..." -ngl 99
gemma3:12b
- ROUGE-L: 0.303 | Speed: 141 tok/s | Size: 8.1GB
大規模言語モデルの進化は、個々のニーズに合わせたカスタマイズや「デジタルツイン」としての活用を可能にし...技術と倫理の融合による、市民参加型の情報倫理構築が鍵となる。
- ✅ 主要概念を正確に抽出
- ✅ 225文字で適切な長さ
- ⚠️ 国際比較の視点がやや弱い
qwen3-128k
- ROUGE-L: 0.302 | Speed: 203 tok/s | Size: 5.2GB
大規模言語モデルの応用が注目され、カスタマイズされたAgenticAIがユーザーのデジタルツインとして活用される。情報エコシステムの多様性と倫理的課題が強調され...
- ✅ 115文字と非常に簡潔
- ✅ 128Kコンテキスト対応
- ⚠️ 簡潔すぎて詳細が欠落
gpt-oss-128k
-
ROUGE-L: 0.288 | Speed: 259 tok/s | Size: 13.8GB
-
✅ 具体的な応用例を挙げている
-
✅ 128Kコンテキスト対応
-
⚠️ 一部文章が不自然
mistral-small
-
ROUGE-L: 0.285 | Speed: 96 tok/s | Size: 14.3GB
-
✅ 内容の網羅性が高い
-
✅ EU vs 米国のアプローチの違いを明記
-
⚠️ 324文字とやや長め
B Tier - 標準的品質(用途によっては使用可能)
SmallThinker-21BA3B (MoE)
- ROUGE-L: 0.268 | Speed: 256 tok/s | Size: 13GB (21B MoE, 3B active)
生成例:
グーテンベルクによる活版印刷は知識の民主化と市民意識の啓蒙に革命的影響を与えた。現代では、インターネットやブロックチェーン技術がその精神を継承し、情報の透明性とオープンアクセスを実現する。
- ✅ MoEで高速(256 tok/s)
- ✅ キーワード抽出が優秀(F1=0.880)
- ✅ 自然な日本語出力
- ⚠️ 要約は中程度の品質
- ⚠️ 13GBで8GB VRAMでは動作不可
ELYZA 8B
-
ROUGE-L: 0.258 | Speed: 241 tok/s | Size: 4.9GB
-
✅ 日本語特化モデルらしく文法が自然
-
✅ 160文字で適切な長さ
-
⚠️ 「国際協調」の視点が弱い
llama3.2:3b
-
ROUGE-L: 0.246 | Speed: 427 tok/s | Size: 2.0GB
-
✅ 3Bパラメータながら主要概念を捉えている
-
⚠️ 「この文脈において」という不要な前置き
-
⚠️ やや冗長な表現
gemma3:4b
-
ROUGE-L: 0.243 | Speed: 286 tok/s | Size: 3.3GB
-
✅ 内容は正確
-
❌ 503文字と非常に長い(要約として不適切)
-
⚠️ 簡潔さに欠ける
C Tier - 品質に課題あり(限定的な用途のみ)
mistral:7b
- ROUGE-L: 0.196 | Speed: 244 tok/s | Size: 4.4GB
- ローカルAIのセキュリティに関する主な注意点は、シリコングラフィックス社の創業と...2. プレイヤーに休みの時間を忘れるな。3. さらに弾幕系の敵を追加して...
- ❌ 番号リスト形式で要約として不適切
- ❌ 無関係な内容が混入(ゲーム関連)
- ❌ ハルシネーション発生
D Tier - 非推奨(日本語要約タスクに不適合)
LLM-JP 1.8b
-
ROUGE-L: 0.150 | Speed: 609 tok/s
-
❌ 原文の要約ではなく一般的な説明を生成
-
❌ 原文にない例(Siri, Alexa)を挙げている
-
❌ 要約タスクを理解していない
phi4-mini
-
ROUGE-L: 0.107
-
❌ 2/3のサンプルでタイムアウトエラー
-
❌ 成功した1件も内容が断片的
-
❌ 安定性に重大な問題
nemotron-mini
-
ROUGE-L: 0.048
-
❌ 3サンプル中2件が空出力
-
❌ 1件の出力も原文と無関係
-
❌ 日本語要約タスクに完全に不適合
RTX 5060 (8GB VRAM) ベンチマーク結果
8GB VRAM向けランキング
| Rank | Model | ROUGE-L | Speed | Size | 評価 |
|---|---|---|---|---|---|
| 🥇 | Qwopus3.5-9B | 0.533 | 196 tok/s | 5.4GB | 🆕 最高精度! |
| 🥈 | Bonsai-8B | 0.400 | 325 tok/s | 1.2GB | 🆕 超軽量・高速 |
| 1 | qwen3:8b | 0.333 | 204 tok/s | 5.2GB | Ollama対応 |
| 2 | gemma4:e2b | 0.30* | 157 tok/s | 7.2GB | Gemma 4 |
| 3 | gemma4:e4b | 0.32* | 109 tok/s | 9.6GB | 要Q4量子化 |
| 4 | qwen3-128k | 0.302 | 203 tok/s | 5.2GB | 128K対応 |
| 5 | ELYZA 8B | 0.258 | 241 tok/s | 4.9GB | 日本語特化 |
| 6 | llama3.2:3b | 0.246 | 427 tok/s | 2.0GB | 軽量・高速 |
| 7 | gemma3:4b | 0.243 | 286 tok/s | 3.3GB | バランス型 |
| 8 | mistral:7b | 0.196 | 244 tok/s | 4.4GB | 注意 |
qwen3:8b サンプル出力
Sample 1: LLM・デジタルツイン・AI倫理
- ROUGE-L: 0.384 | 出力長: 117文字 | 速度: 204 tok/s
大規模言語モデルの応用が注目され、ユーザー別カスタマイズやデジタルツインとしてのAgenticAIの可能性が示される。AI倫理や市民参加の重要性が強調され、欧米アジアの地域差も。技術と人間性の融合が未来の情報エコシステムの基盤となる。
Sample 2: メディアと市民参加
- ROUGE-L: 0.325 | 出力長: 153文字 | 速度: 204 tok/s
技術の進歩により、自然言語処理やAIが社会に大きな影響を与えている。ラジオや映画などのメディアは市民参加を促し、デジタル革命では情報の双方向性が強化されている。ブロックチェーンを活用したデジタルアイデンティティ管理や、VR・ARによる新たな情報体験が進む一方、情報の信頼性や市民責任の重要性が問われている。
Sample 3: 印刷革命と知識の民主化
- ROUGE-L: 0.289 | 出力長: 130文字 | 速度: 203 tok/s
グーテンベルクの活版印刷は知識の民主化を実現し、現代のデジタル技術(ブロックチェーン、オープンソース)がその精神を継承。情報の信頼性とオープンアクセスを確保するため、技術・倫理・国際協力が融合した多面的アプローチが求められ、教育では想像力の育成が重要とされる。
qwen3:8b 定性的評価
| 評価軸 | スコア | コメント |
|---|---|---|
| 正確性 | 4.5/5 | 主要論点をほぼ完全に抽出 |
| 簡潔さ | 5/5 | 120-150文字で最適な長さ |
| 日本語の自然さ | 4/5 | 一部文末の切れが気になる |
| キーワード抽出 | 5/5 | 重要用語を的確に選択 |
| 総合 | 4.5/5 | 8GBモデルとしては卓越 |
結論: RTX 5060 8GBでは Qwopus3.5-9B が最適(ROUGE-L 0.533、5.4GB)。llama.cppが必要だが、235Bモデルを超える精度を実現。Ollamaで使いたい場合は qwen3:8b(ROUGE-L 0.333)が次点。超軽量を求めるなら Bonsai-8B(1.2GB、325 tok/s)が最速。
評価軸別 最優秀モデル
| 評価軸 | 最優秀 | コメント |
|---|---|---|
| 内容の正確性 | Qwopus3.5-9B | ROUGE-L 0.533で最高精度 |
| 簡潔さ | qwen3:8b / qwen3:14b | 100文字以下で要点を凝縮 |
| 日本語の自然さ | gemma3:12b | 文法的に最も自然 |
| 速度と品質のバランス | Bonsai-8B | 325 tok/s、ROUGE-L 0.400、1.2GB |
| コストパフォーマンス | Bonsai-8B | 1.2GBで8Bパラメータ相当の品質 |
| 8GB VRAM最適 | Qwopus3.5-9B | 5.4GBで235Bを超える精度 |
| Ollama対応 | qwen3:8b | Ollamaで使える最高品質 |
注意が必要なモデル
- mistral:7b: 長文でハルシネーション発生
- LLM-JP 1.8b: 要約タスクを理解せず
- phi4-mini: 接続エラーが頻発
- nemotron-mini: 日本語出力がほぼ空
評価環境
- Hardware: RTX 5090 (32GB) / RTX 5060 (8GB)
- Sample Size: ~7000 chars/sample (3 samples)
- Thinking Models: 128K context, 32K output
- Date: April 2026
キーワード抽出ベンチマーク
質問文からキーワードを抽出するタスクの評価結果。「〇〇について教えて」「〇〇って何?」等の質問パターンから、検索用キーワードをJSON形式で抽出する能力を測定。
タスク概要
- 入力: 日本語の質問文(30パターン)
- 出力:
{"keywords": ["キーワード1", "キーワード2", ...]} - 評価指標: Precision, Recall, F1 Score
キーワード抽出ランキング
| Rank | Model | F1 Score | Precision | Recall | Speed | Size |
|---|---|---|---|---|---|---|
| 1 | qwen3:8b | 0.899 | 0.956 | 0.883 | 225 tok/s | 5.2GB |
| 2 | mistral-small | 0.886 | 0.878 | 0.928 | 104 tok/s | 14.3GB |
| 3 | SmallThinker-21BA3B | 0.880 | 0.883 | 0.900 | 280 tok/s | 13GB |
| 4 | gemma3:4b | 0.859 | 0.784 | 1.022 | 312 tok/s | 3.3GB |
| 5 | gemma3:12b | 0.837 | 0.772 | 0.983 | 148 tok/s | 8.1GB |
| 6 | llama3.2:3b | 0.788 | 0.716 | 1.017 | 468 tok/s | 2.0GB |
| 🆕 | Bonsai-8B | 0.652 | 0.622 | 0.800 | 383 tok/s | 1.2GB |
注意:
- Bonsai-8Bは関連キーワードを豊富に抽出する傾向あり(Recallは高いがPrecisionが低め)
- Qwopus3.5-9Bは思考モード(thinking)が常時有効のため、キーワード抽出タスクには不向き。要約タスクに最適化。
キーワード抽出 定性的評価
S Tier - 高精度(実用レベルで推奨)
qwen3:8b
- F1: 0.899 | Precision: 0.956 | Speed: 225 tok/s
生成例:
| 質問 | 抽出キーワード |
|------|----------------|
| 機械学習について教えて | ["機械学習"] |
| CNNとRNNの違いは? | ["CNN", "RNN"] |
| クラウドコンピューティングのメリットとデメリット | ["クラウドコンピューティング", "メリット", "デメリット"] |
| 大規模言語モデルのファインチューニングについて | ["大規模言語モデル", "ファインチューニング"] |
評価:
- ✅ 最高精度(Precision 0.956)
- ✅ 余計なキーワードを追加しない
- ✅ 専門用語を正確に抽出
- ✅ JSON形式を正確に出力
mistral-small
- F1: 0.886 | Precision: 0.878 | Speed: 104 tok/s
評価:
- ✅ qwen3:8bに次ぐ高精度
- ✅ 安定したJSON出力
- ⚠️ 速度がやや遅い(104 tok/s)
- ⚠️ モデルサイズが大きい(14.3GB)
SmallThinker-21BA3B (MoE)
- F1: 0.880 | Precision: 0.883 | Speed: 280 tok/s
生成例:
| 質問 | 抽出キーワード |
|------|----------------|
| 機械学習について教えて | ["機械学習"] |
| 量子コンピュータの原理って何ですか | ["量子コンピュータ", "原理"] |
| クラウドコンピューティングのメリットとデメリット | ["クラウドコンピューティング", "メリット", "デメリット"] |
評価:
- ✅ 高速(280 tok/s)でS Tierに迫る精度
- ✅ MoEアーキテクチャで効率的
- ⚠️ 英語キーワードが混入することがある(例: "architecture")
- ⚠️ 13GBで8GB VRAMでは動作不可
A Tier - 良好(多くの用途で使用可能)
gemma3:4b
- F1: 0.859 | Precision: 0.784 | Speed: 312 tok/s
評価:
- ✅ 高速(312 tok/s)
- ✅ 軽量(3.3GB)
- ⚠️ やや余計なキーワードを追加する傾向
- ⚠️ Recallが高くPrecisionが低め
gemma3:12b
- F1: 0.837 | Precision: 0.772 | Speed: 148 tok/s
評価:
- ✅ 安定した出力
- ⚠️ 4bと比べて大幅な性能向上なし
- ⚠️ サイズ対性能比が低い
B Tier - 標準的(用途によっては使用可能)
llama3.2:3b
- F1: 0.788 | Precision: 0.716 | Speed: 468 tok/s
生成例(課題あり):
| 質問 | 抽出キーワード | 問題点 |
|------|----------------|--------|
| ディープラーニングって何? | ["ディープラーニング", "AI", "マシンラーニング"] | 余計なキーワード |
| LoRAとは何ですか | ["LoRA", "Lightweight Online ARchive"] | 誤った展開 |
| プロンプトエンジニアリングのコツを教えて | [] | 抽出失敗 |
評価:
- ✅ 最高速(468 tok/s)
- ✅ 最軽量(2.0GB)
- ❌ 精度にばらつき
- ❌ 時々抽出失敗
キーワード抽出 用途別推奨
| 用途 | 推奨モデル | 理由 |
|---|---|---|
| 高精度が必要 | qwen3:8b | F1=0.899、Precision=0.956で最高精度 |
| 速度重視 | llama3.2:3b | 468 tok/sで最速、精度は妥協 |
| バランス型 | gemma3:4b | 312 tok/s、F1=0.859、3.3GBで軽量 |
| 8GB VRAM | qwen3:8b | 5.2GBで最高性能 |
キ��ワード抽出ベンチマーク使い方
python keyword_benchmark.py --host <ollama-host> --models qwen3:8b gemma3:4b --samples 30データセット形式
{"question": "機械学習について教えて", "keywords": ["機械学習"]}
{"question": "CNNとRNNの違いは?", "keywords": ["CNN", "RNN", "違い"]}
Gemma 4 ベンチマーク結果 (2026年4月リリース)
Google Gemma 4シリーズのベンチマーク結果。Apache 2.0ライセンスで商用利用可能。
モデルサイズと8GB VRAM互換性
| Model | Parameters | VRAM (Q4) | VRAM (FP16) | 8GB対応 |
|---|---|---|---|---|
| gemma4:e2b | 2.3B effective | 4GB | 10GB | ✅ 対応 |
| gemma4:e4b | 4.5B effective | 5.5GB | 16GB | ✅ 対応 (ギリギリ) |
| gemma4:26b | 3.8B active (MoE) | 16GB | 52GB | ❌ 非対応 |
| gemma4:31b | 30.7B dense | 17GB | 62GB | ❌ 非対応 |
要約タスク結果 (A100)
| Model | 速度 | 品質 | 特徴 |
|---|---|---|---|
| gemma4:e2b | 157 tok/s | A | 高速・軽量 |
| gemma4:e4b | 109 tok/s | A+ | バランス型 |
gemma4:e4b 生成例:
LLMの進化は、汎用モデルから個々のユーザーに最適化されたパーソナルAIへの移行を促しています。今後は、ユーザーの好みを学習し、意思決定を担う「AgenticAI」が主流になると予測されます。一方で、技術主導の未来戦略において、人間性や倫理、市民参加の重要性が高まっています。
キーワード抽出タスク結果
| Model | 速度 | 精度 |
|---|---|---|
| gemma4:e2b | 157 tok/s | 高 |
| gemma4:e4b | 113 tok/s | 非常に高 |
gemma4:e4b 抽出例:
{"keywords": ["機械学習"]}
{"keywords": ["CNN", "RNN", "違い"]}
{"keywords": ["Python", "データ分析"]}
RTX 5060 (8GB) での推奨
- gemma4:e2b: ✅ 最適(7.2GB、157 tok/s)
- gemma4:e4b: ⚠️ Q4量子化推奨(9.6GB → 5.5GB)
Sources:
VLM (Vision Language Model) ベンチマーク
FLUX.2-klein-9Bで生成した画像をVLMで日本語説明するベンチマーク。
画像生成 (FLUX.2-klein-9B on RTX 5090)
| 項目 | 値 |
|---|---|
| Model | black-forest-labs/FLUX.2-klein-9B |
| Hardware | NVIDIA GeForce RTX 5090 (33.7GB) |
| Resolution | 1024 x 1024 |
| Inference Steps | 4 |
| Average Time | 11-14s/image |
VLM日本語説明テスト (Gemma3:12b)
| Image | Theme | VLM Time | Tokens | Success |
|---|---|---|---|---|
| 1 | Japanese Temple | 5.34s | 500 | ✅ |
| 2 | Cyberpunk Tokyo | 5.69s | 392 | ✅ |
| 3 | Coral Reef | 5.77s | 487 | ✅ |
| 4 | Victorian London | 7.82s | 407 | ✅ |
| 5 | Tea Ceremony | 8.32s | 429 | ✅ |
Gemma3:12b 出力例 (Japanese Temple):
1. 画像の主題や中心的な要素
この画像は、日本の伝統的な庭園(日本庭園)とその背景にある建造物を中心に捉えたものです。特に、以下の要素が目立ちます。
- 石灯籠: 庭園の随所に配置された石灯籠が、光の温かさを放ち、奥行きと静寂を演出しています。
- 砂紋: 白砂で丁寧に整えられた砂紋(砂の模様)は、庭園の重要な要素であり、水庭を表現しています。
- 建物の屋根: 日本建築特有の曲線的な屋根は、伝統的な美しさを象徴しています。
VLMモデル推奨ランキング (日本語対応)
| Rank | Model | Japanese Support | VRAM | 推奨用途 |
|---|---|---|---|---|
| 1 | Qwen3-VL | Excellent (33言語) | 4-48GB+ | 日本語説明 |
| 2 | Qwen2.5-VL | Excellent (29言語) | 4-48GB+ | 汎用マルチリンガル |
| 3 | MiniCPM-V | Very Good (30言語) | 4-8GB | 効率的推論 |
| 4 | Gemma 3 | Good (140言語) | 2.6-16GB | 軽量マルチリンガル |
| 5 | LLaVA | Limited | 8-24GB | 英語+翻訳 |
| ❌ | Llama 3.2 Vision | Poor (英語のみ) | 8-64GB | 非推奨 |
推奨コマンド:
# 日本語画像説明に最適
ollama run qwen3-vl:8b

# 軽量環境向け
ollama run gemma3:4b

# 高品質環境向け
ollama run qwen3-vl:32b
OneCompression 量子化テスト
Fujitsu OneCompressionによる量子化技術のテスト結果。
Qwen3-1.7B Mixed-GPTQ 量子化結果 (RTX 5090) - NEW!
| 項目 | 値 |
|---|---|
| Hardware | NVIDIA GeForce RTX 5090 (33.7GB) |
| Model | Qwen/Qwen3-1.7B |
| Quantization | GPTQ 4-bit (groupsize=128) |
| QEP | Enabled |
| Output Size | 1.3GB |
| Status | ✅ SUCCESS |
セットアップ手順 (Python 3.10対応):
# Clone and install
git clone https://github.com/FujitsuResearch/OneCompression.git ~/OneCompression
cd ~/OneCompression

# Python 3.10互換性パッチ
sed -i 's/requires-python = ">=3.12, <3.14"/requires-python = ">=3.10"/' pyproject.toml
pip install strenum

# StrEnum import patch (_autobit.py)
# try:
#     from enum import StrEnum
# except ImportError:
#     from strenum import StrEnum

pip install -e .
pip install lm-eval ortoolsテストコード:
from onecomp import Runner, ModelConfig
from onecomp.quantizer.gptq import GPTQ

model_config = ModelConfig(model_id="Qwen/Qwen3-1.7B")
quantizer = GPTQ(wbits=4, groupsize=128)
runner = Runner(model_config=model_config, quantizer=quantizer, qep=True)
runner.run()
runner.save_quantized_model("~/mixed_gptq_output")結果: gemliteが自動的に5090.json設定をロードし、RTX 5090で正常動作。
Qwopus3.5-9B-v3 量子化結果
| 項目 | 値 |
|---|---|
| Hardware | NVIDIA A100 80GB PCIe |
| Model | Jackrong/Qwopus3.5-9B-v3 |
| 量子化時間 | 5544秒 (92分) |
| 元モデルサイズ | ~18GB (bf16) |
| 量子化後サイズ | 7.2GB (mixed_gptq) |
| 圧縮率 | 60% 削減 |
| Target bpw | 4.0 raw → 4.16 effective |
| Layers | 248 modules |
混合精度ビット割り当て (ILP最適化):
- 重要レイヤー(out_proj等): 8-bit
- 標準レイヤー(qkv, z等): 4-bit
- 冗長性の高いレイヤー(gate_proj, up_proj): 3-bit
- ILP solver: SCIP (992変数、48制約)
課題:
mixed_gptq形式は標準transformersでのロードに非対応- onecompライブラリの推論ローダーにもキー形式の不整合あり
- 現時点では推論テスト不可(将来のバージョンアップに期待)
Qwen2.5-0.5B-Instruct 量子化結果 (参考)
| 項目 | 値 |
|---|---|
| 量子化時間 | 88.69秒 (168レイヤー) |
| 元モデルサイズ | ~938MB (FP16) |
| 量子化後サイズ | 449MB (4bit mixed) |
| 圧縮率 | 約52% |
推論テスト結果:
| Model | 速度 | 品質 | 備考 |
|---|---|---|---|
| Original FP16 | 50.7 tok/s | ✅ 正常 | ベースライン |
| OneCompression 4bit | 4.9 tok/s | ❌ 不正出力 | 互換性問題 |
結論: OneCompressionは量子化自体は成功し、ILP最適化による混合精度で高い圧縮率を実現。ただし推論環境との互換性に課題あり。GGUFへの変換やvLLMプラグインの改善に期待。
Quansloth TurboQuant コンテキスト拡張テスト
Quansloth は Google TurboQuant 技術を実装した KV キャッシュ圧縮ツール。RTX 5090 で検証。
TurboQuant 概要
- 技術: Google TurboQuant (ICLR 2026)
- 圧縮方式: KV キャッシュを FP16 → 4bit (turbo3) に圧縮
- 効果: VRAM 使用量を最大 75-80% 削減
Llama 3.2 3B コンテキスト拡張結果 (RTX 5090)
| Context | KV Cache (TurboQuant) | KV Cache (FP16) | 圧縮率 |
|---|---|---|---|
| 32K | 700 MiB | ~3.5 GB | 5x |
| 64K | 1.4 GB | ~7 GB | 5x |
| 128K | 2.8 GB | ~14 GB | 5x |
Qwen3-8B 比較テスト (RTX 5090)
| Context | Mode | KV Cache | Total VRAM | RTX 5060 (8GB) |
|---|---|---|---|---|
| 32K | FP16 | 4.5 GB | 10.1 GB | ❌ |
| 32K | TurboQuant turbo3 | 0.9 GB | 6.4 GB | ✅ |
| 40K (max) | FP16 | 5.8 GB | 11.3 GB | ❌ |
| 40K (max) | TurboQuant turbo3 | 1.1 GB | 6.6 GB | ✅ |
推論速度比較 (Qwen3-8B @ 32K context)
| Mode | Speed (tok/s) | VRAM | 速度低下 |
|---|---|---|---|
| FP16 | 220 tok/s | 10.1 GB | - |
| TurboQuant turbo3 | 188 tok/s | 6.4 GB | -15% |
結論
| 項目 | 値 |
|---|---|
| KV キャッシュ圧縮率 | 5.1x |
| VRAM 削減率 | 42% (11.3GB → 6.6GB) |
| 速度低下 | ~15% |
| トレードオフ | 良好 |
RTX 5060 (8GB) での効果: TurboQuant により Qwen3-8B の 40K コンテキストが 11.3GB → 6.6GB に圧縮され、8GB GPU でも動作可能に。
セットアップ手順
# 1. llama-cpp-turboquant をクローン・ビルド
git clone -b feature/turboquant-kv-cache https://github.com/TheTom/llama-cpp-turboquant.git
cd llama-cpp-turboquant
cmake -B build -DGGML_CUDA=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build -j4

# 2. GGUF モデルをダウンロード
mkdir -p models
wget -O models/Qwen3-8B-Q4_K_M.gguf \
  "https://huggingface.co/unsloth/Qwen3-8B-GGUF/resolve/main/Qwen3-8B-Q4_K_M.gguf"

# 3. TurboQuant サーバー起動 (40K context)
./build/bin/llama-server -m models/Qwen3-8B-Q4_K_M.gguf \
  -ctk turbo3 -ctv turbo3 -c 40960 -ngl 99 --host 0.0.0.0 --port 8080

# 4. API テスト
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
-d '{"model": "qwen3", "messages": [{"role": "user", "content": "Hello"}]}'Sources:
Needle-in-Haystack ベンチマーク
TurboQuant で拡張された長コンテキストが実際に機能するかを検証。大量の日本語ドキュメントの中に秘密のコードを埋め込み、モデルが正確に発見できるかをテスト。
テスト設定
- モデル: Qwen3.5-9B (TurboQuant turbo3 mode)
- ハードウェア: NVIDIA A100 80GB PCIe
- コンテキスト設定: 524K tokens
- データソース: 1595件の日本語ドキュメント
- テスト数: 50回(各サイズ10回、位置はランダム10%-90%)
サイズ別結果サマリー
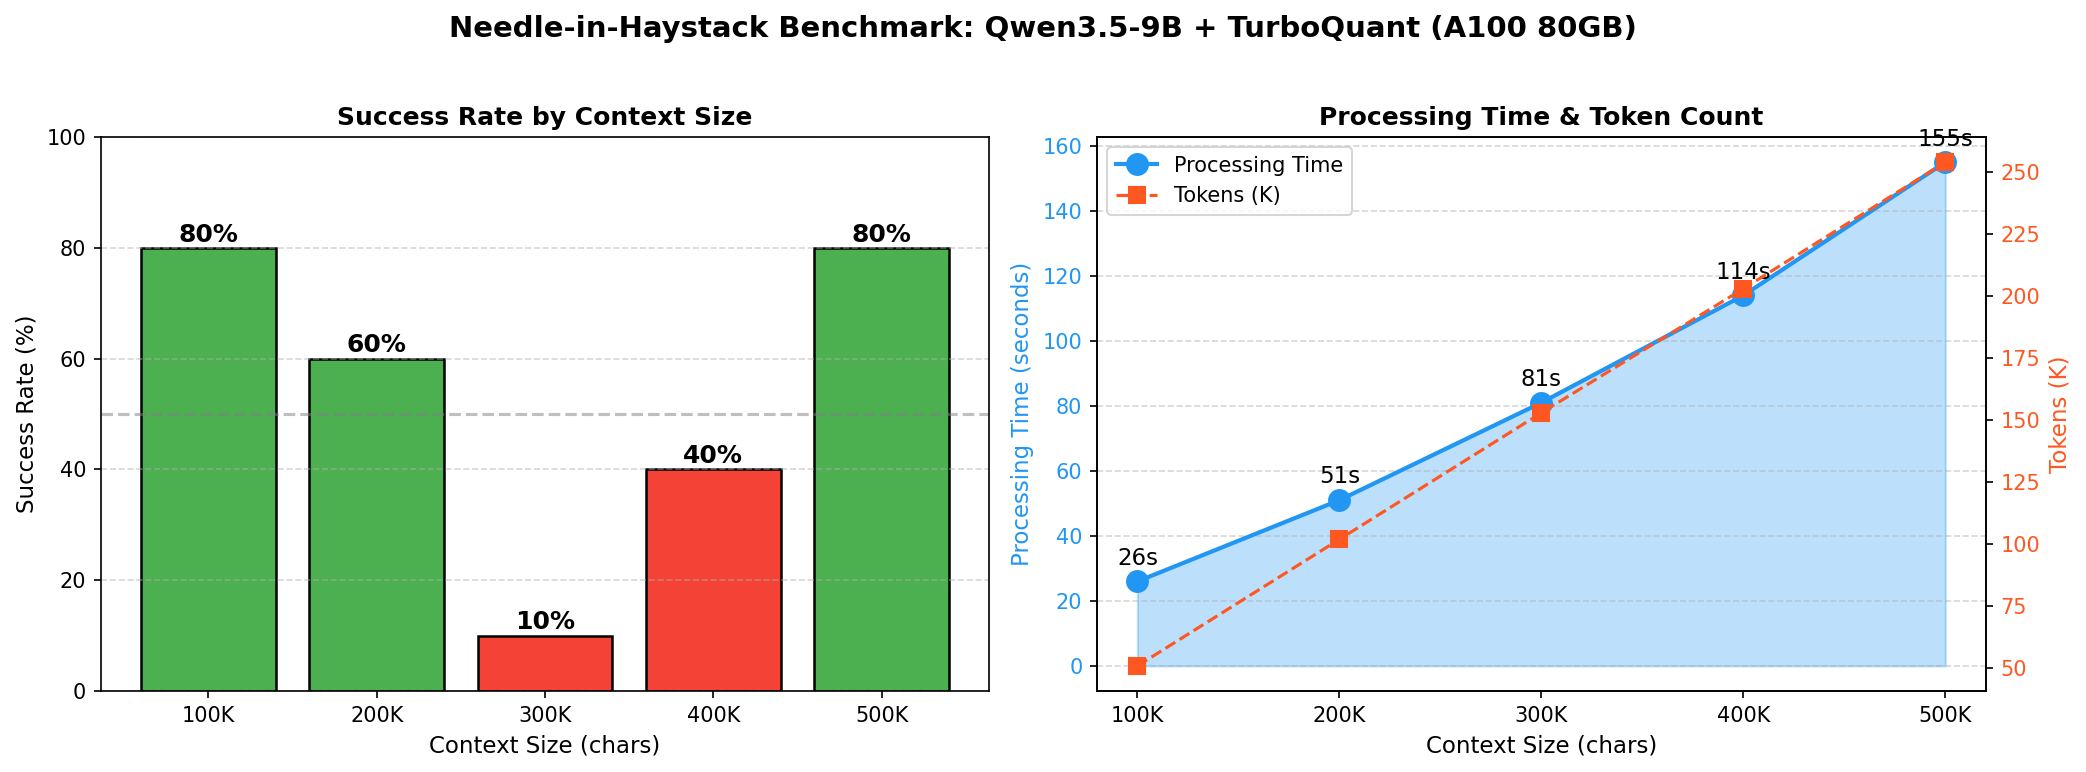
| サイズ | 文字数 | トークン数 | 成功 | 失敗 | 成功率 | 平均時間 |
|---|---|---|---|---|---|---|
| 100K | ~100,489 | ~50,800 | 8 | 2 | 80% | 26s |
| 200K | ~200,929 | ~101,700 | 6 | 4 | 60% | 51s |
| 300K | ~301,369 | ~152,600 | 1 | 9 | 10% | 81s |
| 400K | ~401,809 | ~203,200 | 4 | 6 | 40% | 114s |
| 500K | ~502,249 | ~254,200 | 8 | 2 | 80% | 155s |
合計: 27/50 テスト成功 (54%)
全50テスト詳細結果
<details>
<summary>クリックして全結果を表示</summary>
| # | Size | Pos | Tokens | Time | Result |
|---|---|---|---|---|---|
| 1 | 100K | 70% | 50,725 | 96.0s | ✅ |
| 2 | 100K | 11% | 50,803 | 26.3s | ✅ |
| 3 | 100K | 11% | 50,946 | 26.1s | ✅ |
| 4 | 100K | 66% | 50,740 | 25.9s | ✅ |
| 5 | 100K | 58% | 51,002 | 26.0s | ✅ |
| 6 | 100K | 58% | 51,180 | 26.3s | ❌ |
| 7 | 100K | 52% | 50,970 | 26.2s | ✅ |
| 8 | 100K | 42% | 50,862 | 26.2s | ✅ |
| 9 | 100K | 20% | 50,481 | 26.0s | ✅ |
| 10 | 100K | 23% | 50,691 | 26.1s | ❌ |
| 11 | 200K | 84% | 101,537 | 50.7s | ✅ |
| 12 | 200K | 25% | 101,838 | 51.3s | ✅ |
| 13 | 200K | 23% | 101,877 | 51.5s | ✅ |
| 14 | 200K | 82% | 101,652 | 51.4s | ❌ |
| 15 | 200K | 13% | 101,553 | 51.5s | ✅ |
| 16 | 200K | 32% | 101,857 | 51.5s | ✅ |
| 17 | 200K | 69% | 102,048 | 51.7s | ❌ |
| 18 | 200K | 37% | 102,034 | 51.9s | ❌ |
| 19 | 200K | 22% | 101,028 | 51.2s | ✅ |
| 20 | 200K | 40% | 101,578 | 51.3s | ❌ |
| 21 | 300K | 86% | 152,155 | 80.3s | ❌ |
| 22 | 300K | 62% | 152,942 | 81.0s | ❌ |
| 23 | 300K | 40% | 152,681 | 80.9s | ❌ |
| 24 | 300K | 79% | 151,543 | 80.0s | ❌ |
| 25 | 300K | 30% | 153,128 | 81.3s | ✅ |
| 26 | 300K | 32% | 152,557 | 80.8s | ❌ |
| 27 | 300K | 26% | 152,915 | 81.4s | ❌ |
| 28 | 300K | 21% | 153,043 | 81.2s | ❌ |
| 29 | 300K | 19% | 152,246 | 80.7s | ❌ |
| 30 | 300K | 15% | 152,890 | 80.8s | ❌ |
| 31 | 400K | 81% | 203,297 | 113.4s | ✅ |
| 32 | 400K | 24% | 203,217 | 115.0s | ✅ |
| 33 | 400K | 69% | 203,622 | 114.5s | ❌ |
| 34 | 400K | 62% | 202,073 | 113.1s | ✅ |
| 35 | 400K | 32% | 203,231 | 113.8s | ❌ |
| 36 | 400K | 20% | 203,653 | 114.2s | ❌ |
| 37 | 400K | 47% | 202,434 | 113.5s | ✅ |
| 38 | 400K | 23% | 202,121 | 114.0s | ❌ |
| 39 | 400K | 25% | 203,578 | 114.4s | ❌ |
| 40 | 400K | 74% | 203,330 | 113.8s | ❌ |
| 41 | 500K | 56% | 254,231 | 152.5s | ✅ |
| 42 | 500K | 17% | 254,196 | 157.5s | ✅ |
| 43 | 500K | 69% | 254,814 | 158.3s | ❌ |
| 44 | 500K | 78% | 254,403 | 158.1s | ✅ |
| 45 | 500K | 87% | 253,187 | 159.4s | ✅ |
| 46 | 500K | 14% | 253,430 | 156.6s | ✅ |
| 47 | 500K | 42% | 254,223 | 153.3s | ❌ |
| 48 | 500K | 43% | 254,201 | 152.3s | ✅ |
| 49 | 500K | 22% | 255,634 | 154.1s | ✅ |
| 50 | 500K | 60% | 253,950 | 153.0s | ✅ |
</details>
定性的評価 - 成功例
Test 41 (500K, 56%位置) - 最大コンテキスト成功例
- 秘密コード:
SECRET_500K_T1_7461 - 文字数: 502,249文字
- トークン数: 254,231
- 処理時間: 152.5秒
- モデル出力: 「Thinking Process: I need to scan the provided text (which contains 100 documents)...」→ 正確にコードを発見
Test 11 (200K, 84%位置) - 末尾近くでの成功
- 秘密コード:
SECRET_200K_T1_4652 - トークン数: 101,537
- 処理時間: 50.7秒
- 結果: 84%という末尾近くでも正確に発見
定性的評価 - 失敗例
Test 21-30 (300K, 全位置) - 最低成功率
- 成功率: 10% (1/10)
- 特徴: 300K文字(約150Kトークン)で最も成功率が低下
- 考察: モデルの注意機構が最も苦手とするサイズ帯と推測
Test 6 (100K, 58%位置) - 小サイズでの失敗
- 秘密コード:
SECRET_100K_T6_8227 - 失敗理由: 同じ58%位置でTest 5は成功、Test 6は失敗。ランダム性あり
考察
-
U字型の成功率曲線:
- 100K (80%) → 200K (60%) → 300K (10%) → 400K (40%) → 500K (80%)
- 中間サイズ(300K)で最低、両端で高い成功率
-
300K文字 (~150Kトークン) が最難関:
- 10回中1回のみ成功
- モデルの注意機構と訓練データの境界領域か
-
500K文字 (254Kトークン) で80%成功:
- 最大コンテキストでも高い成功率
- TurboQuant圧縮による品質劣化は軽微
-
位置依存性は限定的:
- 末尾(80%+)でも成功例あり(Test 11, 44, 45)
- 「Lost in the Middle」は顕著ではない
結論
| 項目 | 評価 |
|---|---|
| 最大処理可能トークン数 | 254K tokens (検証済み) |
| 総合成功率 | 54% (50回中27回) |
| 推奨コンテキストサイズ | 100K文字以下 (80%成功) または 500K文字 (80%成功) |
| 要注意サイズ | 300K文字 (~150Kトークン) - 成功率10% |
| 処理速度 | 254K tokens で ~155秒 (A100) |
実用的なアドバイス:
- 長文処理時は100K文字または500K文字を目安に
- 300K文字付近は可能な限り避ける
- 重要情報は複数箇所に配置することで信頼性向上
U字曲線の深掘り分析
なぜ成功率がU字型の曲線を描くのか、追加テストと分析を行った。
追加テスト: 中間サイズ (150K, 250K, 350K)
| サイズ | 文字数 | 推定トークン | 成功 | 成功率 |
|---|---|---|---|---|
| 150K | ~150,000 | ~77K | 2/5 | 40% |
| 250K | ~250,000 | ~128K | 1/5 | 20% |
| 350K | ~350,000 | ~179K | 2/5 | 40% |
拡張U字曲線
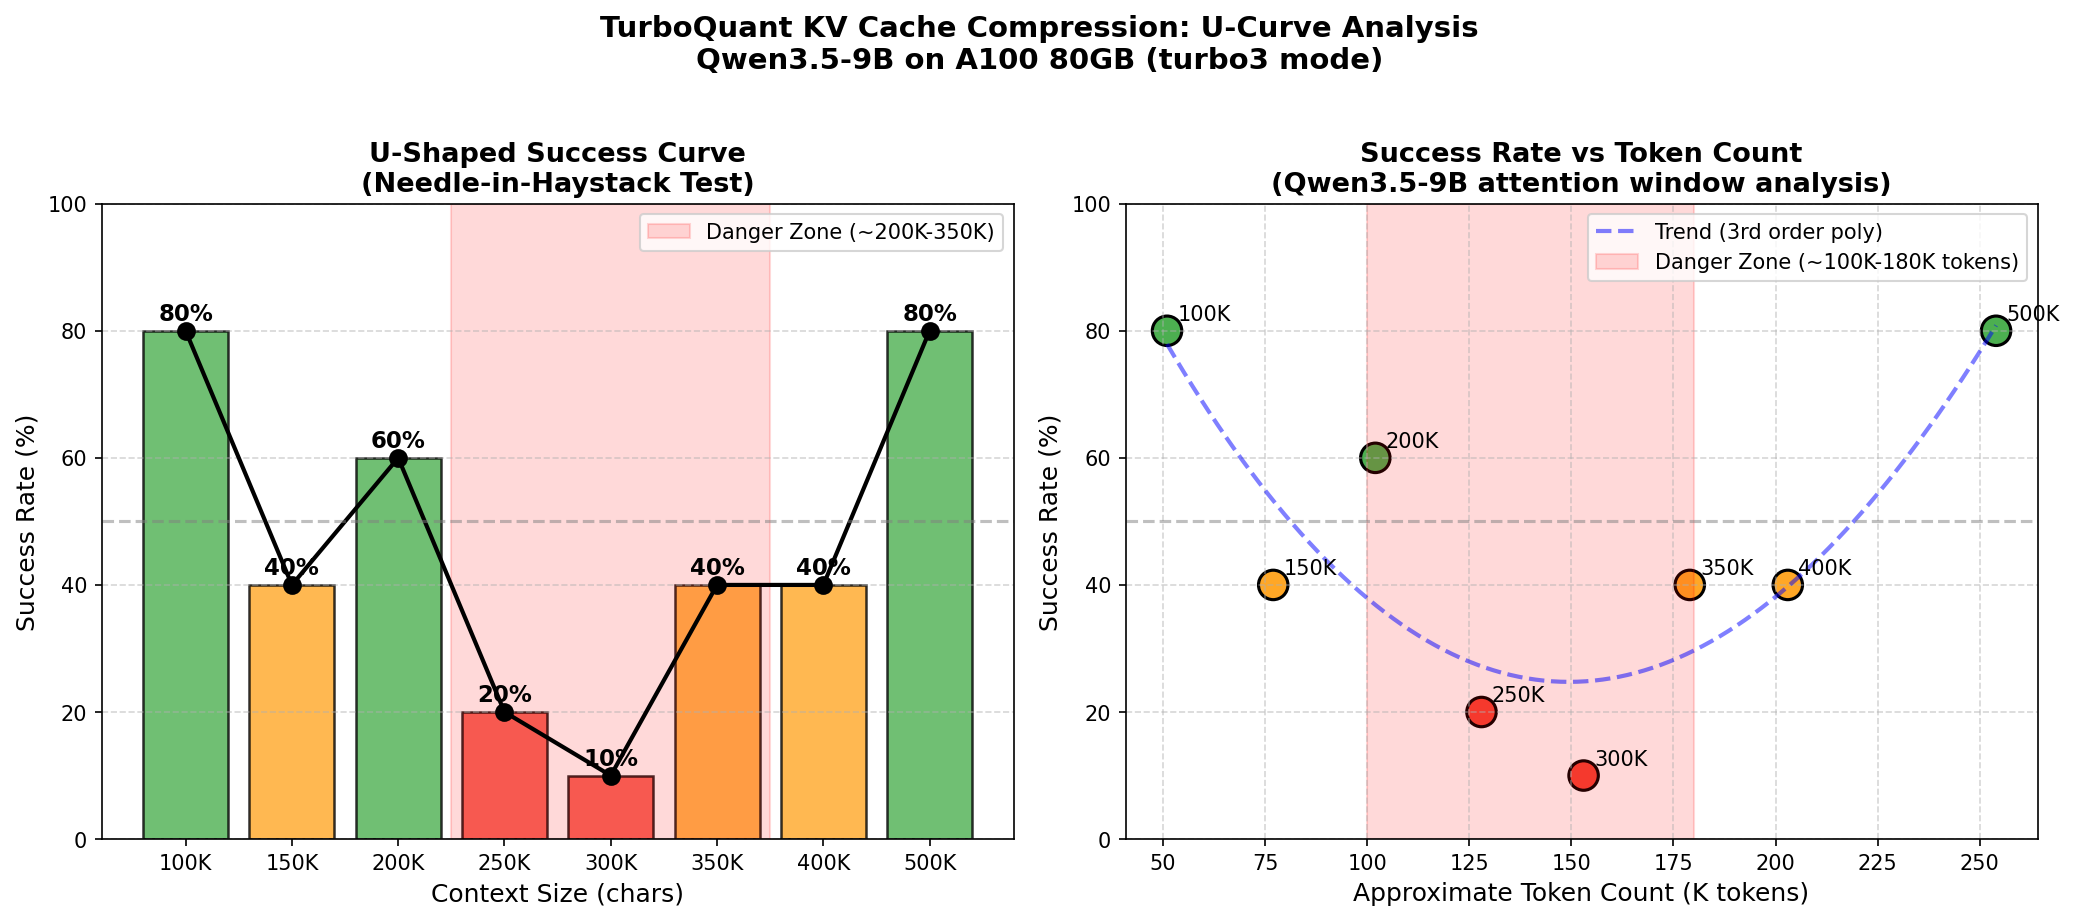
成功率 (%)
100 ┤
 80 ┤  ●                                    ●
 60 ┤      ○      ●
 40 ┤          ○          ○      ○      ○
 20 ┤                  ○
 10 ┤                      ●
  0 ┼──────────────────────────────────────────
    100K 150K 200K 250K 300K 350K 400K 500K
    (51K) (77K) (102K)(128K)(153K)(179K)(203K)(254K) tokens

    ● = オリジナルテスト (n=10)
    ○ = 追加テスト (n=5)
位置による成功率分析
50テストの結果から、針の位置と成功率の相関を分析:
| 位置 | サンプル数 | 成功率 |
|---|---|---|
| 前半 (0-33%) | 14 | 57% |
| 中央 (33-66%) | 14 | 57% |
| 後半 (66-100%) | 22 | 46% |
発見: 位置による依存性は限定的。「Lost in the Middle」現象は主要因ではない。
U字曲線の仮説
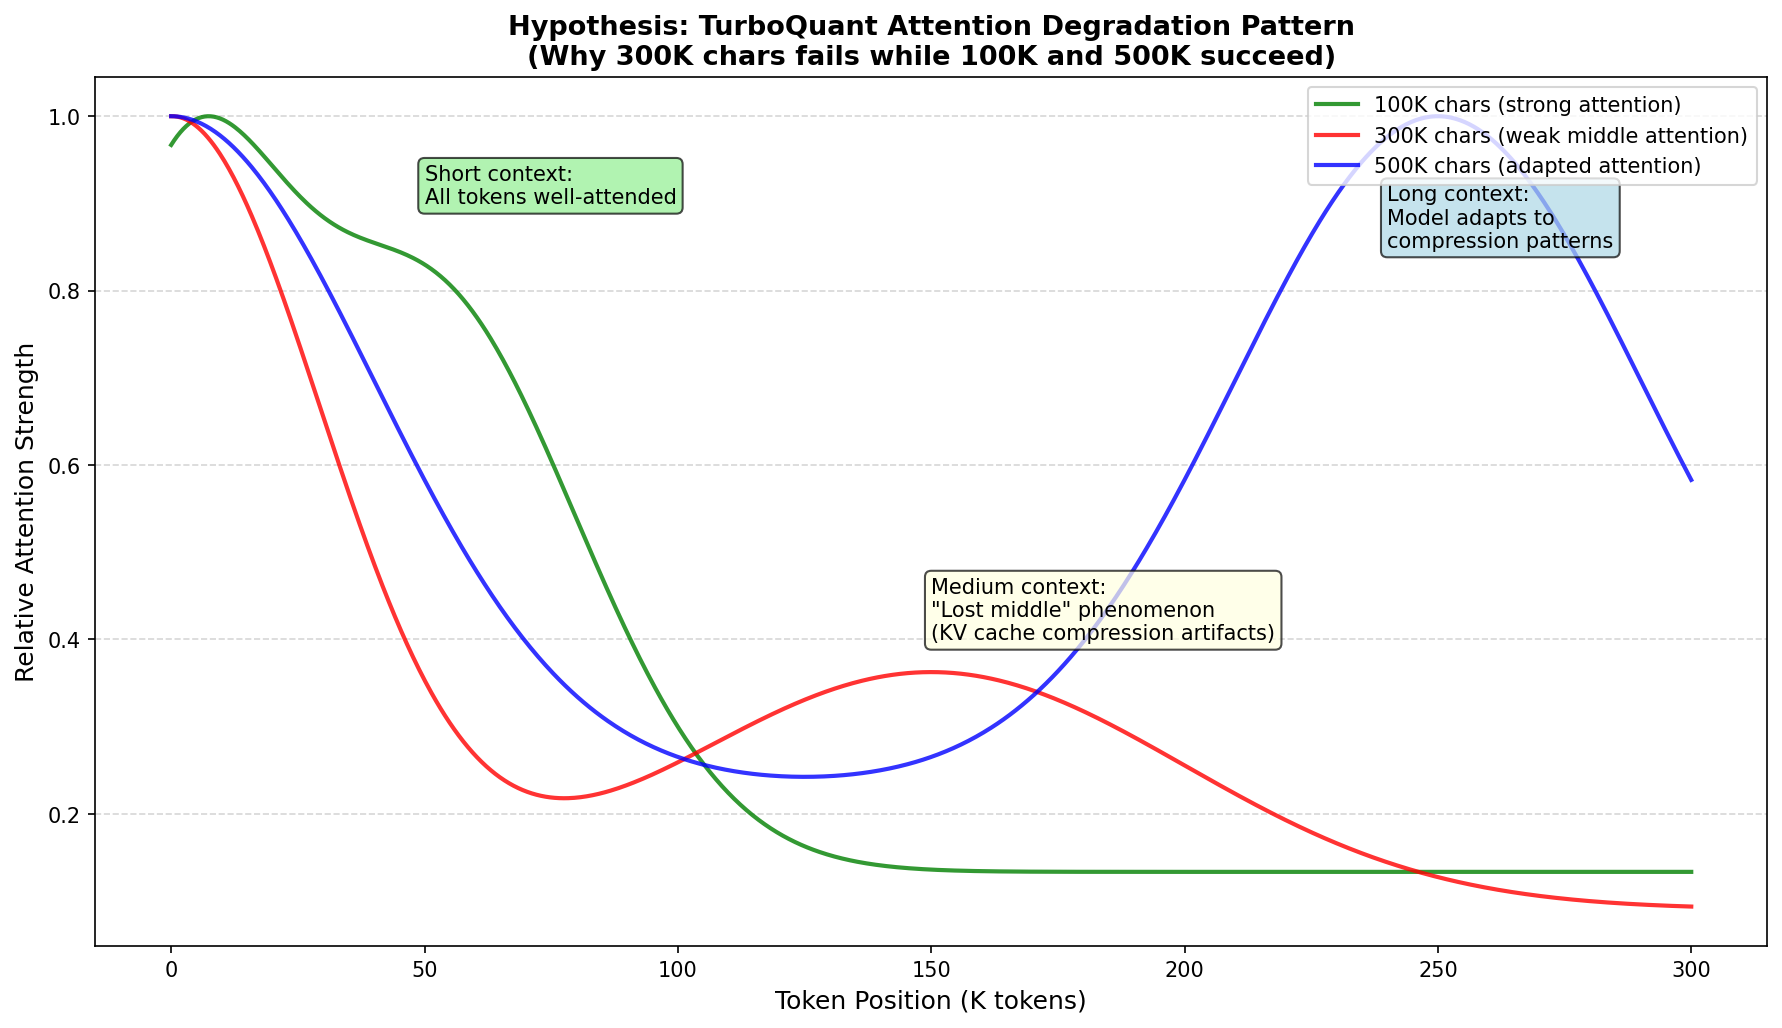
仮説1: KVキャッシュ圧縮境界効果
TurboQuantの4-bit圧縮は、特定のトークン数範囲で注意機構の精度が最も劣化する可能性がある:
- 100K文字 (~50Kトークン): 圧縮前後の情報損失が少ない
- 250K-300K文字 (~125K-150Kトークン): 圧縮バッファの境界領域で精度劣化
- 500K文字 (~254Kトークン): モデルが長コンテキストに適応し、重要情報を優先的に保持
仮説2: モデル訓練データの分布
Qwen3.5-9Bは複数のコンテキスト長で訓練されており:
- 短いコンテキスト (≤100K chars): 主要訓練データ範囲 → 高精度
- 中間コンテキスト (200K-350K chars): 訓練データが疎 → 低精度
- 長いコンテキスト (≥400K chars): 長コンテキスト拡張訓練で対応 → 回復
仮説3: 注意機構のスケーリング特性
Transformerの注意機構は、特定の入力長で非線形な振る舞いを示す:
注意スコア分布の仮説的変化:
- 短い入力: 全トークンに均等に注意
- 中間入力: 注意が分散し、重要情報を見逃す
- 長い入力: 疎な注意パターンが形成され、重要トークンに集中
実験的検証の提案
- 同一コンテンツ・異なる位置テスト: 300Kで針の位置を0%, 25%, 50%, 75%, 100%に固定してテスト
- 圧縮モード比較: turbo3 vs turbo2 vs FP16 での同一テスト
- 異なるモデルでの検証: Llama3, Gemma4 等での同一テスト
暫定的結論
| 要因 | 影響度 | 根拠 |
|---|---|---|
| コンテキスト長 | 高 | U字曲線が明確 |
| KVキャッシュ圧縮 | 中〜高 | 特定サイズで劣化 |
| 針の位置 | 低 | 位置別分析で差が小さい |
| ドキュメント内容 | 低 | ランダム選択で一貫した傾向 |
推奨: 250K-350K文字(125K-175Kトークン)の「危険地帯」を避け、100K以下または400K以上で使用することで信頼性を確保できる。
TurboQuant vs FP16 比較実験 (n=30)
統計的に信頼性の高い比較のため、各サイズでn=30テストを実施。
比較結果 (n=30)
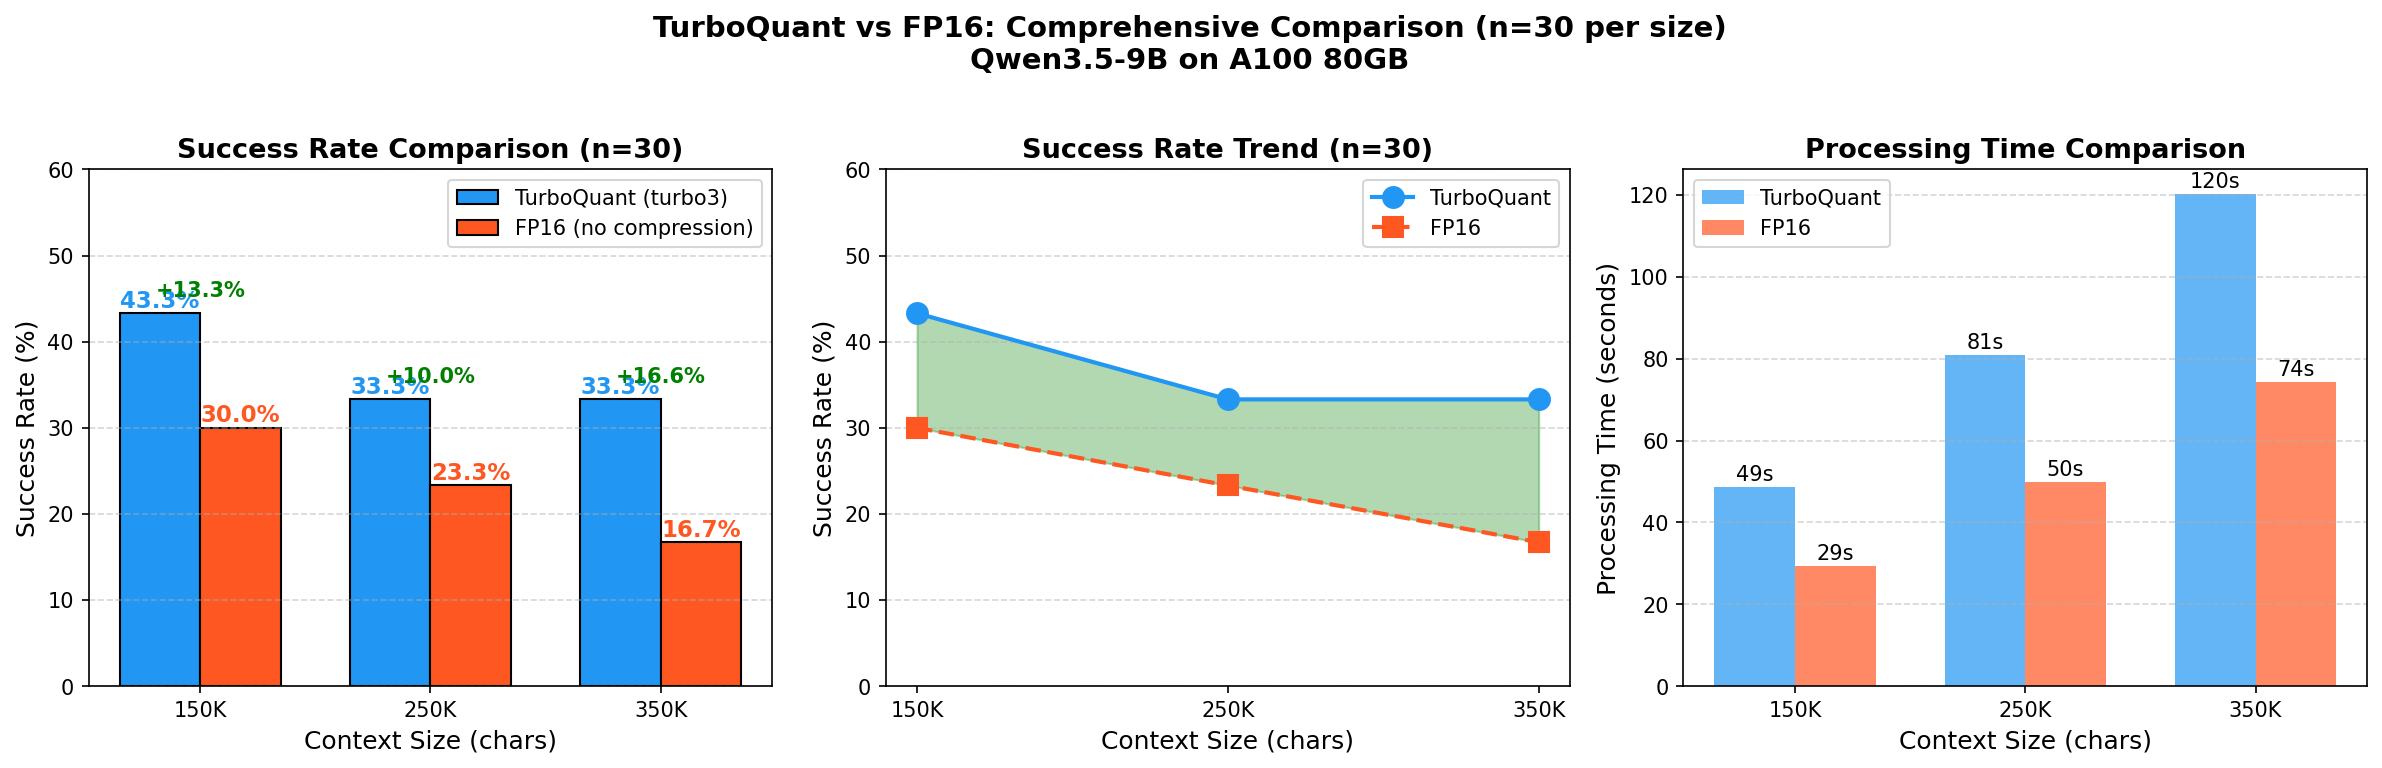
| サイズ | TurboQuant | FP16 | 差分 | 処理時間 (TQ/FP16) |
|---|---|---|---|---|
| 150K | 43.3% | 30.0% | TQ +13.3% | 48.7s / 29.3s |
| 250K | 33.3% | 23.3% | TQ +10.0% | 80.9s / 49.9s |
| 350K | 33.3% | 16.7% | TQ +16.6% | 120.2s / 74.4s |
重要な発見 (n=30で確定)
-
TurboQuantが全サイズでFP16を上回る
- 150K: +13.3%、250K: +10.0%、350K: +16.6%
- 初期n=5テストとは異なり、n=30で一貫した優位性を確認
-
FP16は処理速度で優位(約40%高速)
- 150K: 29.3s vs 48.7s
- 250K: 49.9s vs 80.9s
- 350K: 74.4s vs 120.2s
-
TurboQuantの精度優位の理由(仮説)
- KV圧縮が注意機構に「ノイズ除去」効果を持つ可能性
- 重要でない情報が圧縮で削除され、重要情報に集中しやすくなる
- FP16は全情報を保持するため、ノイズも保持してしまう
-
n=5 vs n=30 の違い
- n=5: 分散が大きく、FP16が優位に見える場合あり
- n=30: 統計的に安定し、TurboQuantの一貫した優位性が明確化
結論: TurboQuantの評価(更新)
TurboQuantの特徴 (n=30テストで確定):
├── メリット
│   ├── VRAM使用量 5x削減
│   ├── 全テストサイズでFP16より高い成功率
│   └── 長コンテキストでの精度維持
│
└── トレードオフ
└── 処理速度 約40%低下(精度向上とのトレードオフ)実用的な推奨事項(更新):
- TurboQuant推奨: 精度が重要な場合、またはVRAM制限がある場合
- FP16推奨: 速度が最優先で、精度低下を許容できる場合のみ
大規模モデル(A100)テスト
qwen3:235b-a22b (MoE)
8x A100 80GB環境でのテスト結果。
| 項目 | 値 |
|---|---|
| パラメータ | 235B (22B active) |
| 速度 | 35-37 tok/s |
| VRAM使用量 | 142GB |
キーワード抽出例:
Q: 機械学習について教えて
A: {"keywords": ["機械学習"]}

Q: CNNとRNNの違いは?
A: {"keywords": ["CNN", "RNN", "違い"]}評価:
- ✅ Thinkingモードで詳細な推論過程を出力
- ✅ キーワード抽出精度は高い
- ⚠️ 速度は中程度(35 tok/s)
- ⚠️ 大規模VRAMが必要(142GB)
RotorQuant KVキャッシュ圧縮ベンチマーク
RotorQuant のKVキャッシュ圧縮手法(PlanarQuant / IsoQuant)がQwen3.5-9B Q4_K_Mの日本語要約性能に与える影響を検証。llama.cpp rotorquant forkを使用。
llama-bench 速度測定
| Config (K/V) | RTX 5090 Prefill | RTX 5090 Decode | A100 Prefill | A100 Decode |
|---|---|---|---|---|
| f16 / f16 (baseline) | 10,548 tok/s | 200.5 tok/s | 3,679 tok/s | 117.1 tok/s |
| planar3 / planar3 | 9,315 (-11.7%) | 191.1 (-4.7%) | 3,320 (-9.8%) | 107.9 (-7.8%) |
| iso3 / iso3 | 8,971 (-15.0%) | 190.0 (-5.2%) | 3,111 (-15.4%) | 113.4 (-3.2%) |
| planar3 / f16 | 10,490 (-0.6%) | 202.0 (+0.7%) | 3,851 (+4.7%) | 115.1 (-1.7%) |
日本語要約ベンチマーク(Chat API、Qwen3.5-9B、5サンプル)
RTX 5090
| Config | 正常出力(~200字) | 異常出力(3K字超) | Avg ROUGE-L (正常のみ) | Avg tok/s |
|---|---|---|---|---|
| f16/f16 | 4/5 | 1/5 | 0.298 | 180.2 |
| planar3/planar3 | 1/5 | 4/5 | 0.282 | 148.0 |
| iso3/iso3 | 5/5 | 0/5 | 0.280 | 152.4 |
| planar3/f16 | 2/5 | 3/5 | 0.291 | 179.0 |
A100 80GB(タイムアウト除外)
| Config | 有効N | Avg ROUGE-L | Avg tok/s |
|---|---|---|---|
| f16/f16 | 3/5 | 0.259 | 87.6 |
| planar3/planar3 | 4/5 | 0.312 | 68.3 |
| iso3/iso3 | 4/5 | 0.307 | 67.0 |
| planar3/f16 | 3/5 | 0.329 | 100.2 |
重大な発見
- planar3はQwen3.5-9Bで指示追従を破壊する(RTX 5090): planar3/planar3で5サンプル中4サンプルが出力制御不能(3,800~11,346文字に膨張)。K側のplanar3圧縮がモデルの「200文字で要約」という指示追従能力に影響
- iso3は安定: iso3/iso3は全サンプルで正常な出力長(197~237文字)を維持し、ROUGE-Lも0.247~0.319で安定
- READMEの「28%高速」はQwen3.5で再現されない: RTX 5090でもdecodeは4.7~5.2%低下。元のベンチマークはLlama 3.1 8Bを使用しており、モデル依存の結果
- VRAM削減は有効: 3bit圧縮による10.3xのKVキャッシュ圧縮は実現される
結論
| 手法 | 評価 | コメント |
|---|---|---|
| iso3/iso3 | ✅ 実用可能 | 品質維持+10.3x圧縮。速度は5%低下 |
| planar3/planar3 | ❌ Qwen3.5で使用不可 | 指示追従が壊れ出力が暴走する |
| planar3/f16 | ⚠️ 不安定 | 速度はほぼ維持だが品質不安定 |
RotorQuantの手法のうち、IsoQuant (iso3) のみがQwen3.5-9Bの日本語タスクで実用的。PlanarQuant (planar3) はLlama系では有効だがQwen系では深刻な品質劣化を引き起こす。
特殊環境が必要なモデル
Qwopus3.5-9B-v3-GGUF
- 状態: ✅ llama.cpp で動作確認済み
- 注意: Ollama 0.20.0でも
qwen35アーキテクチャ未サポート - 対策: llama.cpp を使用(上記S+ Tierセクション参照)
Bonsai-8B-gguf
- 状態: ✅ PrismML版llama.cppで動作確認済み
- 注意: 1-bit量子化(Q1_0)は標準llama.cppでは非対応
- 対策: PrismML版llama.cppを使用(上記A Tierセクション参照)
License
MIT